이 글은 Xilinx Vivado의 부분 재구성(Partial Reconfiguration), 즉 DFX(Dynamic Function eXchange)에 관한 네 편짜리 시리즈의 첫 번째 글입니다. 이 글의 목적은 이 주제의 핵심 개념을 설명하는 것입니다. 이는 다음 글에서 부분 재구성을 적용한 FPGA 프로젝트를 구성하는 실무 절차를 다루기 위한 기반을 마련합니다.
소개
부분 재구성(Partial Reconfiguration)은 FPGA의 일부 영역에 있는 로직을, FPGA의 다른 영역이 정상적으로 동작하는 동안 교체할 수 있게 해 주는 기술입니다. 전원을 켤 때 기능을 프로그래밍하는 초기 비트스트림(bitstream)과 똑같이, 부분 재구성용 비트스트림을 FPGA에 공급하는 방식으로 이루어집니다. 다만 부분 재구성용 비트스트림은 FPGA를 멈추게 하지 않습니다. 대신 특정 로직 요소에 작용하여 그 동작을 제어하는 메모리 셀을 갱신합니다. 특정 로직 블록을 동작 중에 교체하는 핫 스왑(hot swap)과 같은 원리입니다.
Xilinx FPGA는 Virtex-4부터 이 기능을 지원합니다(Intel FPGA는 Series-V부터 지원합니다).
이 글은 부분 재구성의 배경이 되는 개념들을 다루되, 직접 해보는 방식의 기술적 세부 사항은 다루지 않습니다. 다음 글에서 바로 그 실무 절차를 설명할 예정이기 때문입니다. 이 주제는 모든 것이 서로 얽혀 있으므로, 개별 작업으로 나누기 전에 전체 구조를 먼저 이해하는 것이 중요합니다.
다시 설명하면?
먼저 부분 재구성 없이 FPGA의 기능을 변경하는 방법을 살펴보겠습니다. 디자인 계층 구조 어딘가에 어떤 모듈의 인스턴스화(instantiation)가 있다고 가정해 봅시다. 예를 들어 Verilog에서:
   moduleA reconfig_ins
     (
      .clk(clk),
      .this(this_w),
      .that(that_w),
 [ ... ]
      );
또는 VHDL에서:
  reconfig_ins : moduleA
    port map(
      clk        => clk,
      this       => this_w,
      that       => that_w,
 [ ... ]
      );
당연히 프로젝트 어딘가에 moduleA.v 또는 moduleA.vhd라는 모듈이나, moduleA라는 IP 코어(IP core)가 있어서 인스턴스화를 채워 줍니다(하위 모듈 포함). 그런 다음 프로젝트를 구현하여 비트스트림 파일을 얻고, 그것으로 FPGA를 로드합니다. 여기까지는 평소와 똑같은 절차입니다.
그런데 이번에는 위 코드에서 moduleA 대신 moduleB를 쓰고, 로직을 구현하여 비트스트림 파일을 얻는다고 가정해 봅시다. 이렇게 하려면 설계에 moduleB.v나 moduleB.vhd, 또는 moduleB라는 IP 코어가 있어야 합니다.
이제 두 개의 비트스트림 파일이 생겼고, 이 둘은 reconfig_ins라는 인스턴스 안에 들어 있는 로직만 서로 다릅니다. 이 두 비트스트림 사이를 전환하려면 원하는 비트스트림으로 FPGA 전체를 다시 로드해야 합니다. 이 과정에서는 FPGA의 동작이 중단됩니다.
부분 재구성은 이러한 중단 없이 한 버전에서 다른 버전으로 바꿀 수 있게 해 주는 기술입니다. FPGA는 계속 정상적으로 동작하면서, reconfig_ins 안의 로직만 moduleA에서 moduleB로, 또는 그 반대로 바뀝니다. 두 설계를 따로 구현하는 것만으로는 이런 동작이 가능하지 않다는 것은 거의 말할 필요도 없습니다.
moduleA와 moduleB를 재구성 가능 모듈(Reconfigurable Module, RM)이라고 합니다. 이는 이들의 로직이 부분 재구성을 통해 FPGA에 주입될 수 있음을 의미합니다.
동기
부분 재구성을 사용하는 이유는 여러 가지입니다. 예를 들면:
- 플래시 메모리에 쓰지 않고 FPGA 로직을 원격으로 업데이트할 수 있습니다. 예를 들어 FPGA가 PCIe로 컴퓨터에 연결되어 있다면, 호스트 소프트웨어의 업그레이드와 함께 FPGA 로직도 업그레이드하고 싶은 경우가 많습니다. 양쪽 버전이 서로 맞도록 하려면 FPGA 비트스트림을 컴퓨터에 저장해 두고 PCIe 인터페이스를 통해 FPGA를 로드하는 것이 자연스럽습니다(이를 쉽게 구현하는 방법은 이 페이지를 참조하세요).
- 대형 FPGA의 경우, 비트스트림에 모든 로직이 포함되어 있으면 로드 시간이 너무 길어질 수 있습니다. 이 문제는 압축된 비트스트림을 사용하고, 초기 비트스트림에는 꼭 필요한 최소한의 로직만 구현하여 해결할 수 있습니다. 이렇게 하면 FPGA는 반드시 필요한 기능을 빠르게 시작하고, 나머지 로직은 두 번째 단계에서 부분 재구성으로 로드됩니다. 이를 흔히 탠덤 구성(Tandem Configuration)이라고 합니다.
- 동시에 동작할 필요가 없는 서로 다른 작업에 로직 리소스를 재사용하여 FPGA 비용을 줄일 수 있습니다. 예를 들어 FPGA가 여러 영상 필터 중 하나를 구현한다고 합시다. 그러면 현재 사용 중인 필터만 FPGA 로직을 차지합니다. 다른 필터가 필요해지면 필터용으로 할당된 FPGA 영역만 다시 로드하고, 나머지 FPGA는 정상적으로 계속 동작합니다.
- JTAG를 통해 특정 로직 요소를 업데이트할 수 있습니다. 예를 들어 FPGA에서 실행되는 마이크로프로세서의 실행 코드가 들어 있는 블록 RAM(Block RAM)이 여기에 해당합니다. 이렇게 하면 소프트웨어의 개발 주기를 빠르게 가져갈 수 있습니다.
- 동작 중인 설계에 데이터 프로브(data probe)나 디버깅 도구를 삽입할 수 있습니다. 특히 어떤 문제가 FPGA 구현 버전에 따라 나타났다 사라지는 경우에 부분 재구성이 유용합니다. 이런 문제는 대개 클록이나 타이밍 등 설계의 근본적인 결함을 시사하지만, 그것은 또 다른 이야기입니다.
부분 비트스트림
FPGA 설계에 어느 정도 경험이 있다면 이런 단순한 루틴에 익숙할 것입니다. 설계의 소스 코드(그리고 IP 코어)를 조금 수정하고, 구현 도구를 돌린 다음, 문제없이 통과했는지 확인합니다. 그런 다음 JTAG를 통해 비트스트림을 FPGA에 로드합니다. 또는 플래시 장치에 비트스트림 이미지를 로드하기도 합니다.
모두 이런 방식에 익숙하기 때문에, 비트스트림을 FPGA 전체를 신비한 정보로 채우는 그저 많은 데이터 덩어리로 오해하기 쉽습니다. 실제로 비트스트림은 로드되는 동안 FPGA가 순차적으로 실행하는 일련의 명령으로 구성됩니다. 물론 일반적인 비트스트림은 FPGA 전체에 정보를 로드하지만, 그것도 절차의 진행을 제어하는 여러 명령을 통해 이루어집니다. 더 중요한 점은 이 명령들이 어떤 로직 요소에 어떤 데이터가 로드될지를 결정한다는 것입니다.
비트스트림 자체가 영향을 받는 로직 요소를 지정하므로, 일부 로직 요소만 변경하고 나머지 로직 요소는 그대로 두는 비트스트림을 만드는 것이 가능합니다. 이것이 부분 재구성의 초석입니다.
다만 부분 비트스트림은 이미 FPGA에 로드되어 있는 로직과 호환되어야 합니다. 단순히 잘못된 로직 요소를 덮어쓰지 않으면 되는 문제가 아닙니다. 초기 비트스트림은 부분 비트스트림과 밀접하게 연결되어 있습니다. 특히 초기 비트스트림은 부분 비트스트림이 변경하는 영역 안에 있는 로직 및 라우팅 리소스까지 사용하기 때문입니다. 부분 비트스트림이 초기 비트스트림에 맞게 올바르게 만들어지면 이 미묘한 상호작용은 전혀 눈에 띄지 않습니다. 그렇지 않으면 FPGA는 변경되지 말아야 할 기능까지 포함하여 거의 확실히 오동작할 것입니다.
부분 비트스트림 로드하기
부분 구성 비트스트림을 FPGA에 전달하는 방법에는 특별한 제약이 없습니다. FPGA가 동작하는 동안 로드할 수만 있다면, 비트스트림을 로드할 수 있는 어떤 인터페이스로도 가능합니다. 여기에는 JTAG 인터페이스도 포함되므로, 부분 구성용 .bit 파일은 평소처럼 Hardware Manager로 로드할 수 있습니다. 더 흥미로운 점은 전용 ICAP(Internal Configuration Access Port)을 사용하여 FPGA 자체 로직 내부에서 로드할 수 있다는 것입니다. 비트스트림을 로드하는 FPGA 로직 패브릭 부분은 그 과정 내내 그대로 있어야 하므로, ICAP 포트는 부분 재구성 전용으로 사용할 수 있습니다.
ICAP은 FPGA의 비트스트림 로드 하위 시스템에 대한 인터페이스일 뿐이며, 비트스트림의 출처에 대해 아무것도 규정하지 않습니다. 따라서 비트스트림 데이터가 FPGA에 도달하는 방식이나, 어디에 어떻게 저장되는지에는 제한이 없습니다. 그저 ICAP에 공급하는 FPGA 로직이 비트스트림을 어떻게든 사용할 수 있기만 하면 됩니다.
예를 들어 Xillybus는 보드에 PCIe 또는 USB 3.x 인터페이스가 있다면, 컴퓨터에서 해당 인터페이스를 통해 비트스트림 파일을 ICAP으로 보낼 수 있는 간단한 수단을 제공합니다.
정적 로직
부분 재구성을 올바르게 수행하려면 그 반대편도 고려해야 합니다. 바로 정적 로직(static logic)입니다. 정적 로직은 FPGA 설계에서 변경되지 않고 그대로 유지되어야 하는 부분을 가리키는 일반적인 용어이며, 초기 비트스트림이 로드된 때부터 존재합니다.
이 로직은 두 가지 측면에서 정적입니다. 첫째는 기능적 측면입니다. 정적 로직은 FPGA 설계(HDL 및 IP 코어) 중 FPGA가 처음 시작한 이후 중단 없이 동작하는 부분입니다. 둘째는 배치 측면인데, 이것도 그에 못지않게 중요합니다. 정적 로직은 정적으로 할당된 로직 패브릭 안의 사이트(site)에만 배치됩니다. 이 사이트들에서는 이후 어떤 조작도 허용되지 않습니다.
실제 설계에서는 정적 로직이 변경되지 않는 것만으로는 충분하지 않습니다. FPGA의 다른 부분이 변경되는 동안 정적 로직이 계속 올바르게 동작하는 것도 중요합니다. 정적 로직과 변경되는 로직 사이에는 거의 틀림없이 서로 연결된 네트(net)가 있으므로, 모든 것이 원활하게 동작하도록 만드는 것은 FPGA 설계자의 책임입니다. 이 시리즈의 세 번째 글에서 이 주제를 다룹니다.
정적 로직과 재구성 로직의 분리
부분 재구성이 아예 가능하려면 정적 로직과 재구성 로직이 엄격하게 분리되어 있어야 합니다. 특히 FPGA의 물리적 로직 요소가 분리되어 있어야 하며, 그래야 비트스트림이 FPGA에 로드될 때 정적 로직이 들어 있는 사이트가 영향을 받지 않습니다.
이 요구 사항이 무엇을 뜻하는지 이해하려면, 먼저 우리 모두에게 익숙한 방식을 살펴보겠습니다.
일반적인 FPGA 구현 과정은 HDL 설계의 합성(synthesis)으로 시작합니다. HDL에서 모듈을 인스턴스화한다고 해서 모듈 사이에 어떤 분리가 생기는 것은 아닙니다. 오히려 그 반대입니다. 합성 도구(synthesizer)는 인스턴스화를 로직이 동작해야 하는 방식에 대한 설명으로 취급할 뿐입니다. 따라서 합성 도구는 전체 설계를 하나의 크고 납작한 로직 덩어리로 자유롭게 볼 수 있습니다. 모듈 경계를 넘나드는 최적화는 허용될 뿐만 아니라 바람직하며, 실제로도 자주 일어납니다. 예를 들어 모듈 X의 어떤 레지스터가 모듈 Y의 전혀 관련 없는 레지스터와 우연히 동일한 기능을 한다면, 레지스터 하나는 제거되고 남은 하나가 두 모듈에서 모두 사용됩니다. 물론 합성 도구에게 그렇게 하지 말라고 명시적으로 지시하지 않은 경우입니다.
HDL 합성이 완료되면 합성된 네트리스트(netlist)는 설계에 포함된 IP 코어(있다면)의 네트리스트와 합쳐집니다.
다음으로 이 커다란 로직 요소 덩어리가 FPGA 로직 패브릭 전체에 배치되고, 타이밍 제약(timing constraints) 및 기타 목표를 달성하도록 배선이 이루어집니다. 설계의 서로 다른 부분에 속하는 로직이 같은 슬라이스(slice) 안에 들어가거나, FPGA의 반대편에 배치될 수 있습니다. 설계에서 아주 작은 변경만 있어도 배치가 극적으로 달라질 수 있습니다. 이런 혼란스러운 방식은 무해합니다. 각 구현이 독립적이며, 로직이 FPGA 패브릭 위에 어떻게 흩어져 있는지는 아무도 신경 쓰지 않기 때문입니다.
부분 재구성으로 돌아와서, 앞서 말했듯이 이 기능을 아예 가능하게 하려면 정적 로직과 재구성 로직 사이에 명확한 구분이 있어야 합니다. 이를 보장하기 위해 계층적 설계(Hierarchical Design)라는 기법이 사용됩니다. 전체 설계를 PCB 위의 물리적 부품처럼 구성 요소의 모음으로 보는 것입니다. 한편으로 각 구성 요소, 즉 인스턴스화된 모듈에는 로직 패브릭의 특정 영역이 할당됩니다. 그리고 각 구성 요소는 서로 분리되어야 하므로, 마치 부품을 따로 생산하듯 각각을 따로 합성하는 것이 당연합니다.
이 개념을 부분 재구성과 연결해 보겠습니다. 결국 설계 작업에는 두 가지 주요 차이점이 생깁니다.
- 플로어플래닝(floorplanning): FPGA 설계자는 재구성 로직을 위해 FPGA 패브릭 안의 물리적 영역을 명시적으로 할당해야 합니다. 이 영역을 재구성 파티션(reconfigurable partition)이라고 합니다. 나머지 영역에는 정적 로직이 채워집니다.
- 합성: 재구성 로직(및 관련 IP 코어)의 합성은 정적 로직과 분리하여 수행됩니다. 그 결과 재구성 로직과 정적 로직에 대한 독립적인 네트리스트가 생깁니다.
Pblock
Vivado에서 플로어플래닝 단위를 부르는 용어는 Pblock입니다. Pblock은 Vivado 내부에서 배치 정보를 담는 자리 표시자일 뿐입니다. Pblock을 만들고 여기에 로직 셀을 추가한 다음, FPGA 로직 사이트의 그룹(세트)을 추가하는 Tcl 함수가 있습니다. Vivado는 이를 배치 제약 조건으로 해석합니다. 즉, Pblock에 추가된 로직 셀은 Pblock에 할당된 사이트에만 배치될 수 있습니다. 결국 Pblock은 XDC 파일에 들어 있는 다른 제약 조건들과 마찬가지입니다.
Pblock은 흔히 Vivado의 GUI에서 합성된 설계나 구현된 설계를 열고, FPGA의 그래픽 표현 위에 사각형 영역을 그려서 정의합니다. 그러면 그려진 사각형 안의 모든 로직 요소를 포함하는 Pblock이 만들어집니다. 더 정확히 말하면 모든 유형의 로직 요소가 포함되는 것은 아니고, 플로어플래닝이 허용되는 로직 요소만 포함됩니다(해당 FPGA 제품군에 따라). 따라서 Vivado는 사각형을 로직 요소의 범위로 변환합니다.
이러한 범위를 XDC 파일을 직접 편집하여 설정하는 것도 전적으로 가능합니다. 또한 여러 사각형으로 구성된 영역을 만드는 것도 허용되므로, 모양이 단순한 사각형 하나보다 더 복잡해질 수 있습니다. 다만 Xilinx 문서(UG909)에서는 라우팅에 어려움이 생기지 않도록 모양을 단순하게 유지하라고 권장합니다.
Kintex-7용 XDC 파일의 예는 다음과 같습니다.
create_pblock pblock_pr_block_ins
add_cells_to_pblock [get_pblocks pblock_pr_block_ins] [get_cells -quiet [list pr_block_ins]]
resize_pblock [get_pblocks pblock_pr_block_ins] -add {SLICE_X118Y0:SLICE_X153Y99 SLICE_X118Y250:SLICE_X145Y349 SLICE_X0Y0:SLICE_X117Y349}
resize_pblock [get_pblocks pblock_pr_block_ins] -add {DSP48_X5Y100:DSP48_X5Y139 DSP48_X5Y0:DSP48_X5Y39 DSP48_X0Y0:DSP48_X4Y139}
resize_pblock [get_pblocks pblock_pr_block_ins] -add {RAMB18_X4Y0:RAMB18_X6Y39 RAMB18_X4Y100:RAMB18_X5Y139 RAMB18_X0Y0:RAMB18_X3Y139}
resize_pblock [get_pblocks pblock_pr_block_ins] -add {RAMB36_X4Y0:RAMB36_X6Y19 RAMB36_X4Y50:RAMB36_X5Y69 RAMB36_X0Y0:RAMB36_X3Y69}
아래 이미지는 이것을 구현된 설계에서 본 모습입니다. 재구성 파티션(이 예에서는 거의 로직이 들어 있지 않은 pblock_pr_block_ins)이 보라색으로 표시되어 있습니다. 그 모양은 위의 각 resize_pblock 명령에 나열된 세 범위의 합집합으로 만들어집니다.
이 그림에서 배치된 모든 로직은 청록색으로 그려집니다. 로직의 대부분은 정적 영역에 속하며, 작은 영역 안에 모여 있는 것이 분명하게 보입니다.
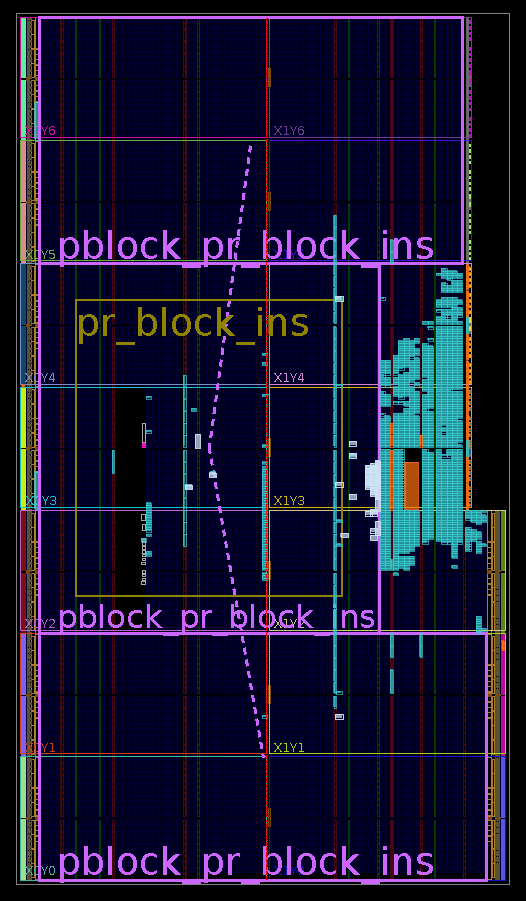
제약 조건에 의해 영역이 제한되는 것은 슬라이스, RAM, DSP48뿐이라는 점에 유의하세요. series-7 FPGA에서 부분 재구성이 제어할 수 있는 로직 유형은 이들뿐입니다. 그 외의 모든 것, 즉 실질적으로 “순수 로직”이 아닌 모든 것은 정적 설계에 속해야 합니다.
Ultrascale FPGA 이후 세대에서는 사실상 모든 로직을 부분 재구성으로 다시 로드할 수 있습니다.
Pblock에는 추가적인 제약도 있지만, 여기서 UG909의 6~8장을 반복할 필요는 없습니다.
어쨌든 구현된 설계를 열어 FPGA 뷰를 확대하고 축소하면서 로직 요소가 FPGA에서 어떻게 조직되어 있는지 관찰해 보는 것은 언제나 좋은 생각입니다. 특히 같은 유형의 로직이 컬럼(column)을 이루고 있다는 점을 눈여겨보세요. 때로는 컬럼 중간에 이런 균일성을 깨는 로직 요소가 몇 개 있습니다. 특히 ICAP 블록, PCIe 블록 같은 특수 로직 요소가 그렇습니다.
Pblock이라는 주제는 부분 재구성에만 해당하는 것은 아닙니다. 예를 들어 이 절에서 설명한 내용은 계층적 설계에서 Pblock을 사용할 때도 모두 적용됩니다.
플로어플래닝에 대해 더
여기서 직관에 반하는 사실 두 가지를 소개하겠습니다. 플로어플래닝의 그래픽 표현은 FPGA 지도 위에 그려진 도형으로 구성되지만, 이는 배치 제약 조건이 제어하는 유형의 로직에만 적용됩니다. 따라서 FPGA 슬라이스의 거의 전부가 부분 재구성용으로 할당되더라도, 그 슬라이스들에 완전히 둘러싸인 다른 로직 요소의 섬은 정적 로직에 속할 수 있습니다. 예를 들어 ICAP 블록 자체가 부분 재구성용으로 할당된 직사각형 한가운데 있더라도 전혀 문제가 되지 않습니다.
부분 재구성 비트스트림이 특정 로직 요소만 겨냥하고 다른 요소는 그대로 두기 때문에 이 사실이 그렇게 이상하게 느껴지지는 않습니다. 그렇다면 라우팅은 어떨까요? ICAP 블록이 재구성 로직 한가운데 박혀 있다면, 정적 로직의 슬라이스까지 이어지는 배선은 어떻게 처리될까요?
이 질문이 두 번째 직관에 반하는 사실로 이어집니다. 정적 설계용 라우팅은 재구성 영역 내부의 리소스를 사용합니다. 이 라우팅은 부분 재구성이 진행되는 동안 내내 그대로 유지됩니다. 그렇지 않으면 정적 로직이 아니겠지요. 따라서 재구성 영역 안에서 재구성 로직용 라우팅은 바뀌지만, 정적 로직용 라우팅은 변하지 않습니다. 이 주제 전체에서 무언가 마법처럼 느껴진다면 바로 이 사실입니다. 또한 정적 로직과 호환되지 않는 부분 비트스트림을 사용하면 FPGA 전체가 완전히 교란될 가능성이 있는 이유이기도 합니다.
물론 그 반대는 성립하지 않습니다. 재구성 로직은 위의 XDC 예에서 명시적으로 나열된 리소스 외에는 아무것도 사용하지 않습니다. 라우팅 리소스의 관점에서 보면, 부분 재구성 비트스트림이 로드되는 동안 정적 영역에서는 아무것도 변하지 않습니다. 따라서 재구성 로직은 정적 영역에 절대로 영향을 미치지 않습니다. 음, 거의 맞습니다. 재구성 영역의 모양이 단순한 직사각형이 아닌 경우, Vivado는 라우팅이 재구성 영역 밖으로 나가도록 허용할 수 있습니다. 이는 라우팅을 개선하기 위한 목적으로 Ultrascale FPGA에서만 발생합니다.
이쯤에서 분명해져야 할 점은 플로어플래닝을 그리는 규칙이 간단하지 않다는 것입니다. 좋은 소식은 Vivado가 플로어플래닝 규칙을 위반하면 상당히 유용한 정보를 담은 Critical Warning(치명적 경고)을 생성한다는 것입니다. 따라서 시행착오를 거쳐 적합한 플로어플랜을 찾는 것이 합리적인 작업 방식입니다.
부모 구현과 자식 구현
재구성 로직의 구현과 관련하여 중요한 점은, FPGA 안의 모든 경로(path)가 타이밍 제약을 충족해야 하고, 그것이 재구성 로직이 로드되기 전과 후 모두에 해당해야 한다는 것입니다. 따라서 재구성 로직을 정적 로직과 분리하여 단독으로 구현하는 것은 불가능합니다. 구현은 각 재구성 모듈에 대해 항상 FPGA 전체를 대상으로 수행됩니다. 타이밍 제약(및 기타 제약)은 각 구현에 적용됩니다.
이 점을 명확히 하기 위해 위의 moduleA와 moduleB 예로 돌아가 보겠습니다. 이 예에서 Vivado는 moduleA를 포함한 전체 설계의 구현을 수행한 다음, moduleB에 대해서도 동일한 작업을 수행합니다. 부수적으로 이 두 경우 각각에 대한 일반 비트스트림 파일이 생성됩니다.
강조할 점이 있습니다. 모든 구현은 전체 초기 비트스트림과 부분 비트스트림을 모두 생성합니다. 부모 구현(Parent Implementation)이든 자식 구현(Child Implementation)이든 모든 구현이 그렇습니다. 따라서 FPGA에 전원을 켤 때 이 중 어떤 초기 비트스트림으로든 로드할 수 있습니다.
moduleA에서 moduleB로 부분 재구성을 통해 전환하려면 정적 파티션의 모든 것이 정확히 동일해야 합니다. 여기에는 로직 자체, 배치, 라우팅이 포함됩니다. 이를 위해 Vivado는 한 시나리오(예: moduleA 포함)를 부모 구현으로 구현합니다. 그런 다음 다른 모든 시나리오(예: moduleB 포함)에 대해 자식 구현을 수행합니다. 정확한 방법은 이 시리즈의 마지막 글에서 자세히 다루지만, 짧게 요약하면 다음과 같습니다.
Vivado는 먼저 moduleA에 대한 부모 구현을 평소처럼 계층적 설계 방식으로 실행합니다. 즉, 정적 로직과 재구성 로직의 합성이 분리되어 수행되고, 플로어플래닝 제약 조건이 서로 다른 FPGA 사이트에 배치되도록 강제합니다. 이 두 가지 차이점 외에는 일반적인 구현이 수행됩니다. 특히 이 특정 시나리오에서 최적의 결과가 나오도록 배치 및 배선(place and route)이 수행됩니다. 물론 플로어플래닝 제약과 분리 합성 때문에 성능이 최적이 아닐 수는 있습니다.
다음 단계는 moduleB에 대한 자식 구현을 수행하는 것입니다. 정적 설계의 합성은 이미 부모 구현을 위해 수행되었으므로 필요하지 않습니다. 따라서 재구성 로직에 대해서만 합성이 수행됩니다.
그런 다음 구현은 부모 구현과 같은 방식으로 수행되지만, 한 가지 중요한 차이점이 있습니다. 모든 정적 로직의 배치 및 배선은 부모 구현의 결과와 동일하도록 강제된다는 점입니다. 이 제약 아래에서 재구성 로직의 배치 및 배선은 최적의 결과를 위해 수행됩니다.
부모와 자식 관계의 핵심은, 자식 구현이 부모 구현이 끝난 지점에서 시작하되 재구성 로직만 자신의 로직으로 교체한다는 것입니다. 그런 다음 자식 구현은 정적 로직 영역의 어떤 것도 건드리지 않은 채 평소처럼 계속됩니다.
모든 자식 구현은 정적 로직의 배치와 라우팅에 맞추어야 하기 때문에, 일반적인 구현에 비해 타이밍 제약을 달성하기가 더 어려울 수 있습니다. 실제로 장애물은 두 가지입니다.
- 설계를 정적 로직과 재구성 로직으로 계층적으로 분리하면, 경계를 넘나드는 최적화가 불가능해집니다.
- 정적 로직의 배치 및 배선이 재구성 로직에 반드시 최적이라고 할 수는 없습니다.
부모 구현으로 선택할 재구성 모듈을 정할 때는 이 점을 염두에 두어야 합니다. 예를 들어 타이밍 제약 달성이 가장 어려운 모듈을 선택할 수 있습니다. 또는 정적 로직과의 연결 방식에 있어 다른 모듈들을 대표하는 모듈을 선택할 수도 있습니다. 반대로, 로직이 전혀 없는 재구성 모듈(이른바 “그레이박스”)을 선택하여 정적 로직의 중립적인 구현을 얻는 방법도 있습니다.
비트스트림 사용과 관련하여, Vivado에서 부분 재구성 프로젝트의 구현은 모든 비트스트림이 최신 상태이고 서로 호환될 때 끝난다는 것이 기본 패러다임입니다. 즉, 어떤 구현의 초기 비트스트림이든 처음에 FPGA를 로드하는 데 사용할 수 있습니다. 그 후에는 어떤 구현의 부분 비트스트림이든 로드할 수 있습니다.
따라서 첫 번째 “Generate Bitstream”은 부모 구현과 모든 자식 구현을 시작합니다. 이후 컴파일에서는 평소처럼 업데이트가 필요한 런(run)만 Vivado가 수행합니다.
DFX(Dynamic Function eXchange) 마법사
이 마법사는 Tools 메뉴에서 시작할 수 있으며, 부모 구현과 자식 구현을 정의하고, 특히 어떤 구현에 어떤 재구성 모듈이 들어 있는지를 정의하는 역할을 합니다.
이 마법사를 설명하는 가장 쉬운 방법은, 자식 구현을 추가할 때 마법사가 만들어 내는 Tcl 명령을 보는 것입니다.
create_reconfig_module -name bpf -partition_def [get_partition_defs pr ]
add_files -norecurse /path/to/pr_block1.v  -of_objects [get_reconfig_modules bpf]
create_pr_configuration -name config_2 -partitions [list pr_block_ins:bpf ]
create_run child_0_impl_1 -parent_run impl_1 -pr_config config_2 -flow {Vivado Implementation 2020}
이 Tcl 시퀀스를 마지막 줄부터 첫 줄까지 거꾸로 살펴보겠습니다.
마지막 줄에서는 자식 구현 런(Child Implementation run)이 생성됩니다. 새 런의 이름은 “child_0_impl_1”로 지정되고, 부모 런으로는 “impl_1”이 선택됩니다. 그에 못지않게 중요한 것은 이 새 런의 구성(configuration)이 “config_2”로 설정된다는 점입니다.
“config_2”는 세 번째 줄에서 정의되며, “bpf”가 “pr_block_ins”라는 재구성 파티션에 사용될 재구성 모듈임을 나타냅니다. “pr_block_ins”는 앞에서 이미 언급했지만, “bpf”는 무엇일까요?
첫 번째 줄에서는 reconfig_module이 생성되고 이름이 “bpf”로 지정됩니다. 이 이름은 해당 로직이 어떤 기능을 하는지 알아보기 쉽도록 붙이는 임의의 이름일 뿐입니다. 두 번째 줄에서는 특정 Verilog 파일이 이 재구성 모듈에 추가된다는 것을 나타냅니다.
요컨대 이 네 줄은 새 자식 구현을 만들고, 재구성 모듈을 만들기 위해 특정 Verilog 파일의 합성이 필요하다는 점을 지정합니다. 또한 Tcl 환경에는 “bpf”와 “config_2”라는 두 객체가 생성됩니다.
이제 DFX 마법사로 돌아가 보겠습니다. 이 마법사는 설계 소스, 재구성 모듈, 구성, 구현 런 사이의 관계를 보여 주는 GUI 도구입니다. 위와 같은 Tcl 명령을 만들어 내기 위한 정보를 전달하는 편리한 방법일 뿐입니다.
이 도구가 지나치게 복잡해 보일 수 있습니다. 하지만 그것은 예제가 단순하기 때문입니다. 실제 설계에서는 reconfig_module에 여러 소스 파일이 속해 있고, IP 코어가 할당되어 있을 가능성이 높습니다. 따라서 GUI가 작업을 더 쉽게 만들어 줍니다.
그런데 왜 구성(“config_2”)이 필요할까요? “bpf”와 “pr_block_ins”의 연결을 create_run 명령에서 직접 만들면 안 되는 이유는 무엇일까요? 이 글은 재구성 파티션이 하나뿐인 경우만 다루기 때문에 다시 한번 타당한 질문입니다. 재구성 파티션이 여러 개 있다면, 각 파티션에 어떤 재구성 모듈을 넣을지를 구성이 정의합니다. 따라서 각 조합에 config_* 같은 이름을 붙이는 것이 합리적입니다.
그렇다면 파티션이 여러 개일 때, 가능한 모든 재구성 모듈 조합에 대해 구현을 만들어야 할까요? 이 질문은 이 시리즈의 주제와는 관계가 없으므로, 다음 절로 건너뛰어도 좋습니다.
Vivado의 구현은 설계 전체, 즉 정적 로직과 재구성 로직을 함께 대상으로 하며, 전체가 타이밍 제약을 충족하는지 확인한다는 점을 기억하세요. 따라서 파티션이 여러 개인 경우, 부분 재구성을 안전하게 사용하려면 모든 파티션을 같은 구현 런의 결과로 만들어진 부분 비트스트림으로 로드하는 것이 좋습니다. 다시 말해 모든 부분 비트스트림이 동일한 구성(예: “config_2”)으로 생성되어야 하며, 그래야 이 부분 비트스트림들의 조합이 도구로 검증된 하나의 구현 결과가 됩니다. 특히 이 구현이 타이밍 제약을 충족하는 것으로 알려져 있습니다.
그런데 재구성 모듈들이 서로 상호 작용하지 않는다면, 즉 모든 재구성 모듈의 최상위 포트가 정적 로직에만 연결되고 서로 연결되지는 않는다면, 각 파티션을 개별적으로 취급해도 무엇이 문제가 될 수 있는지 저는 알 수 없습니다. 실제로 Vivado는 서로 다른 런에서 나온 부분 비트스트림을 섞어 사용할 때 FPGA 전체의 타이밍을 명시적으로 승인하지 않습니다. 그러나 정적 로직과 관련된 모든 경로(path)가 타이밍 제약을 충족했고, 모든 구현 런에서 정적 로직이 정확히 동일하다면, 그것으로 충분하지 않을까요? 공식 문서는 이 문제에 대해 명확한 정보를 주지 않는 것 같습니다.
라우팅과 파티션 핀
퍼즐에는 아직 한 조각이 빠져 있습니다. 정적 로직과 재구성 로직 사이를 연결하는 라우팅입니다. 부모 구현은 관련 구성에 포함된 재구성 로직에 최적이 되도록 설계의 배치 및 배선을 수행한다는 점을 기억하세요. 그런데 자식의 재구성 모듈은 같은 재구성 파티션에 맞아 들어가면서 정적 설계와도 연결되어야 합니다. 라우팅 중 적어도 일부는 정적 로직에 속하므로 변경할 수 없습니다.
여기서 파티션 핀(Partition Pin)이 등장합니다. 개념적으로는 재구성 로직을 물리적 부품으로, 파티션 핀을 PCB에 연결되는 금속 핀으로 생각할 수 있습니다.
그러나 실제로 파티션 핀은 FPGA의 라우팅 리소스 좌표계에서 어떤 위치일 뿐입니다. 파티션 핀은 정적 로직의 라우팅이 끝나고 재구성 로직의 라우팅이 이어지는 지점입니다. 이들의 유일한 중요성은 부모 구현과 자식 구현이 그 위치에 대해 서로 합의한다는 것입니다.
이러한 앵커 포인트를 만드는 데 LUT나 플립플롭 같은 물리적 리소스는 필요하지 않으며, 파티션 핀 자체가 추가 라우팅 지연을 만들지도 않습니다. 파티션 핀으로 들어가고 나가는 라우팅 구간은 당연히 지연을 만들지만, 파티션 핀 자체는 지연을 추가하지 않습니다.
파티션 핀의 위치는 부모 구현이 수행되는 동안 도구가 자동으로 선택하며, 자식 구현은 그에 맞출 수밖에 없습니다. 다시 말해 정적 로직과 재구성 로직 사이의 라우팅은 부모 구현이 정한 지점에서 시작되며, 자식 구현은 재구성 파티션 안에서 최선을 다할 수밖에 없습니다. 일부 파티션 핀이 자식의 재구성 로직에 불리한 위치에 배치되어 타이밍 제약 달성이 어려워질 수도 있습니다.
파티션 핀은 흔히 재구성 파티션의 경계 근처 어딘가에 함께 모여 있습니다. Vivado는 특정 설계에 너무 전문화되지 않은 사이트를 선택하도록 설계된 것처럼 보입니다.
그러나 부모 구현 중에 타이밍 제약을 달성하기 위해 필요했다면, 파티션 핀은 재구성 파티션 내부 어디에나 있을 수 있습니다. 정적 설계는 재구성 파티션 내부의 라우팅 리소스를 사용할 수 있다는 점을 기억하세요. 따라서 정적 라우팅 구간 중 일부가 재구성 파티션 안으로 들어가도 전혀 문제가 없습니다.
타이밍 제약과 파티션 핀 관련 문제를 방지하려면, 재구성 모듈의 출력 포트가 레지스터(register) 출력이고 입력도 레지스터에서 샘플링(sampling)되도록 하는 것이 유리합니다. 마찬가지로 정적 로직도 비슷하게 레지스터를 사용하는 것이 좋습니다. 사실 가능하고 설계를 필요 이상으로 복잡하게 만들지 않는다면, 이 규칙을 따르는 것이 언제나 좋은 생각입니다.
그레이박스
DFX 마법사에 대해 한 가지 더 언급할 것은 그레이박스(greybox)입니다. Edit Configuration 창에서는 일반 재구성 모듈 대신 그레이박스를 재구성 모듈로 지정할 수 있습니다. 그레이박스는 Vivado가 생성하는 가짜 모듈입니다. 실제 재구성 모듈의 포트에 맞추어져 있지만, 실제 로직 대신 포트 핀마다 LUT 하나가 들어 있습니다. 입력용으로 생성된 LUT는 반대쪽 끝에 아무것도 연결되지 않고, 출력용 LUT는 0 값을 만듭니다. 벡터 포트의 경우에는 벡터의 각 비트마다 LUT가 생성됩니다.
부모 구현에서 그레이박스를 사용하는 것은 좋은 생각이 아닐 수 있습니다. 배치 및 배선 과정이 너무 쉬워지기 때문입니다. 재구성 모듈들이 서로 매우 다르더라도, 어느 정도는 도구에 도전이 되는 간단한 모듈을 작성하는 편이 나을 것입니다.
그러나 최소한의 로직만 담긴 초기 비트스트림 파일을 만들 목적이라면, 그레이박스 모듈만 포함하는 자식 구현이 유용할 수 있습니다. 모든 구현이 완전한 비트스트림을 만들고, 그것들이 모두 정확히 동일한 정적 로직을 가지므로 모두 초기 비트스트림으로 사용할 수 있다는 점을 기억하세요.
Clearing Bitstream(Ultrascale 전용)
이 절은 Ultrascale FPGA에만 해당합니다(Ultrascale+는 아님).
위에서 언급했듯이 모든 구현은 두 개의 비트스트림을 만듭니다. 하나는 전체 설계용 비트스트림으로, 관련 재구성 모듈이 포함된 채 FPGA를 초기에 로드하는 데 사용할 수 있습니다. 두 번째 비트스트림은 동일한 재구성 모듈로 부분 재구성을 수행하기 위한 것입니다.
Ultrascale 디바이스에는 세 번째 비트스트림인 clearing bitstream이 있으며, 각 구현에서 생성됩니다. 이 비트스트림은 부분 비트스트림을 보내기 전에 FPGA로 보내야 합니다. 주의할 점은 FPGA로 보내는 clearing bitstream이 곧 로드될 비트스트림과 일치해야 하는 것이 아니라, FPGA에 현재 들어 있는 로직과 일치해야 한다는 것입니다. 따라서 FPGA의 현재 상태를 계속 추적해야 합니다. 다른 FPGA 제품군에서는 필요하지 않은 작업입니다.
Clearing bitstream을 로드하면 재구성 모듈이 종료됩니다. 실제로 로직을 바꾸지는 않지만, 새 부분 비트스트림이 로드되어 동작을 시작할 때까지 이 모듈의 출력 포트는 임의의 값을 표시할 수 있습니다.
UG909에 따르면, 잘못된 재구성 모듈의 clearing bitstream, 즉 이미 FPGA에 들어 있는 로직과 일치하지 않는 clearing bitstream을 로드하면 정적 로직도 교란될 수 있으며, 따라서 재구성 메커니즘 자체의 오작동을 일으킬 수 있습니다.
Xilinx 문서는 clearing bitstream을 먼저 로드하지 않고 부분 비트스트림을 로드하면 어떤 일이 생기는지에 대해 다소 모호합니다. UG909 9장에는 먼저 이렇게 나와 있습니다. “새 재구성 모듈(Reconfigurable Module)용 부분 비트스트림을 로드하기 전에, 기존 재구성 모듈을 클리어(clear)해야 합니다.” 따라서 결론은 clearing bitstream이 필수라는 것입니다.
그런데 몇 줄 아래에서 같은 가이드는 “If a clearing bit file is not loaded, initialization routines (GSR) have no effect”라고 말합니다. 이는 clearing bit 파일을 로드하지 않아도 괜찮으며, 모든 동기식 요소(원칙적으로 RAM과 플립플롭)가 알 수 없는 상태로 시작해도 괜찮다는 뜻입니다. 제가 clearing bitstream을 건너뛰고 직접 실험해 본 결과 문제를 보지 못했지만, 그것은 아무것도 증명하지 않습니다.
따라서 Ultrascale FPGA에서는 FPGA에 무엇이 로드되어 있는지를 반드시 추적해야 합니다. 예를 들어 재구성 모듈에 출력 포트를 하나 추가하고, 각 재구성 모듈마다 다른 상수 값(ID 코드)을 출력하게 하는 방법이 있습니다. 이렇게 하면 정적 로직이 현재 어떤 재구성 모듈이 로드되어 있는지 식별할 수 있습니다. 이런 ID 코드는 그 자체로도 좋은 생각이 될 수 있습니다.
Plugin 사용 사례와 Remote Update 사용 사례
Vivado가 채택한 부모-자식 방법론은 분명히 특정 사용 사례에 맞추어 설계된 것으로 보입니다. 저는 이 사용 사례를 플러그인 사용(plugin usage)이라고 부르겠습니다. 즉, 모든 가능한 기능을 항상 FPGA 안에 두는 대신, 그때 필요한 재구성 모듈만 로드하여 FPGA 비용을 줄이는 방식입니다. 예를 들어 FPGA가 여러 영상 필터를 구현하는 데 사용된다면, 부분 재구성을 통해 각 필터를 재구성 모듈로 구현하고, 현재 필요한 필터만 FPGA에 다시 로드할 수 있습니다.
Xilinx는 부분 구성(Partial Configuration)을 가리켜 DFX(Dynamic Function eXchange)라는 용어를 사용하는데, 이는 이 기술이 주로 의도된 용도를 반영하는 것으로 보입니다.
부분 재구성의 목적이 바로 이것이라면 부모-자식 방식은 잘 작동합니다. 비트스트림 파일의 완전한 키트가 생성됩니다. 초기 비트스트림 중 아무것이나 FPGA 초기화에 사용할 수 있고, 이후 모든 재구성 비트스트림을 부분 재구성에 사용할 수 있습니다. 프로젝트의 새 버전이 출시되면 모든 비트 파일로 구성된 전체 키트가 교체됩니다.
그러나 또 다른 사용 패턴이 있습니다. 저는 이것을 Remote Update(원격 업데이트)라고 부르겠습니다. 부분 재구성을 버전 업그레이드의 수단으로, 아마도 먼 미래에 사용하는 경우입니다. 이 시나리오에서는 초기 비트스트림이 어떤 시점에 출시되며 이후에는 변경할 수 없습니다. 나중에 부분 비트스트림이 출시되는데, 이것들은 초기 비트스트림과 호환되어야 합니다. 이후 출시는 수년간 계속될 수 있습니다.
Remote Update의 경우 부모-자식 방식은 그대로 사용하기 어려울 수 있습니다. 부모 구현을 반복하지 않고도 자식 구현을 실행하여 새 부분 비트스트림을 얻는 것이 가능하지만, 이것을 오랫동안 유지하기는 어려울 수 있습니다. 예를 들어 정적 로직의 소스 코드가 우연히 변경되면 부모의 설계가 무효화되고, 그 결과 부모 구현을 다시 수행해야 합니다. 새 정적 로직은 이전 정적 로직과 호환되지 않으므로, 그것을 기반으로 만들어진 부분 비트스트림도 원래의 초기 비트스트림과 함께 사용할 수 없습니다.
따라서 부분 재구성을 시간이 지나면서 FPGA 설계를 계속 업데이트하는 방법으로 사용하려면, 구현 절차를 적절히 조정할 필요가 있습니다. 이 주제는 이 시리즈의 마지막 글에서 다룹니다.
비트스트림 압축
이 내용은 부분 재구성과 직접 관련되지는 않지만, 특히 FPGA의 빠른 시작을 보장하기 위해 초기 비트스트림 파일을 작게 유지하고 싶을 때가 있습니다. 이런 맥락에서 부분 재구성은 빠른 시작 후에 초기 구동 과정을 마무리하는 수단이 됩니다. 이 작업은 같은 데이터 소스(예: SPI 플래시)에서 수행하거나, 완전히 다른 소스(예: PCIe 인터페이스)에서 수행할 수 있습니다.
비트스트림 압축은 초기 비트스트림과 부분 비트스트림 모두에 허용됩니다.
압축된 비트스트림을 요청하려면 XDC 파일에 다음 줄을 추가하면 됩니다.
set_property bitstream.general.compress true [current_design]
이상으로 이론적인 부분을 마칩니다. 다음 글에서는 부분 재구성을 사용하도록 프로젝트를 구성하는 실제 단계를 보여 드리겠습니다.