이 페이지는 MGT(Multi-Gigabit Transceiver)를 소개하는 페이지 시리즈 중 네 번째입니다. 앞선 페이지들에서는 MGT와 함께 사용되는 몇 가지 프로토콜과 몇 가지 인코딩 방식에 대해 다루었습니다.
소개
이 시리즈의 첫 번째 페이지에서 이미 언급했듯이, MGT는 단지 정교한 종류의 SERDES에 불과합니다. MGT를 정교하게 만든 이유 중 하나는 특정 프로토콜을 구현하는 데 도움이 되는 몇 가지 구성 블록(building block)이 MGT 내부에 들어 있기 때문입니다. 이 페이지에서는 이 구성 블록들 중 일부가 왜 존재하는지 설명합니다.
이러한 유닛들을 포함하는 MGT 부분을 보통 PCS(Physical Coding Sublayer, 물리 코딩 하위 계층)라고 합니다. PCS 내부의 일부 로직은 인코딩이나 디코딩과 전혀 관련이 없기 때문에, 이 이름은 다소 오해의 소지가 있습니다.
아래는 일반적인 MGT의 블록 다이어그램으로, 전체적인 맥락에서 PCS의 위치를 보여 줍니다.
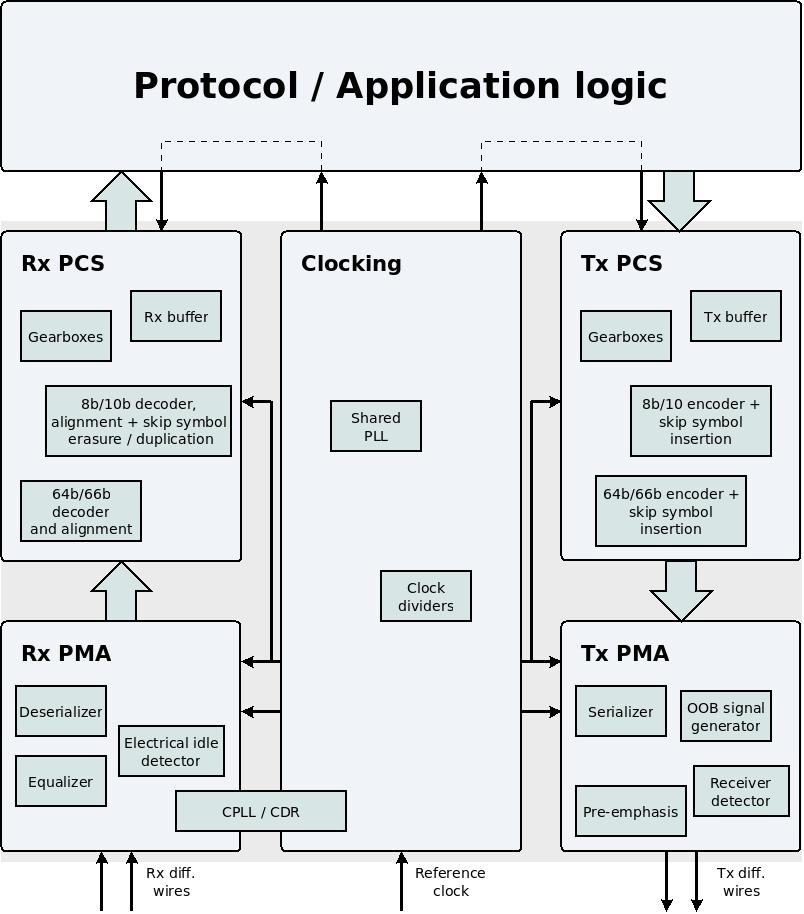
PCS는 PMA와 사용자 애플리케이션 로직 사이의 모든 것을 포함합니다. 데이터 전송에 사용되는 MGT 부분을 가리켜 Tx PMA와 Tx PCS라는 표현을 사용하겠습니다. 마찬가지로, 데이터 수신에 사용되는 부분을 가리켜 Rx PMA와 Rx PCS라고 부르겠습니다.
Tx PCS는 애플리케이션 로직이 MGT에 전송할 데이터를 넘겨주는 입력 포트에서 시작됩니다. Tx PCS는 물리 전선을 통해 전송할 준비가 된 비트들로 구성된 병렬 워드(parallel word)가 만들어졌을 때 역할을 마칩니다. 이 병렬 워드는 직렬화 및 전기 신호 변환을 위해 Tx PMA로 넘겨집니다.
마찬가지로 Rx PCS는 Rx PMA가 수신하고 역직렬화한 병렬 데이터 워드에서 시작하여, MGT가 데이터를 애플리케이션 로직에 넘겨주는 출력 포트에서 끝납니다.
PCS는 병렬 워드에 대해서만 동작하는 로직으로 구성되므로, PCS의 모든 기능은 로직 패브릭(fabric)에서도 구현할 수 있다는 점은 분명합니다. 그럼에도 이 로직이 MGT 내부에 구현되어 있는 이유는, 많은 구성 블록들이 하드 IP(hard IP)로 구현되는 이유와 같습니다. 어떤 프로토콜들은 PCS의 인코딩 기능을 활용합니다. 다른 프로토콜들(예: Xillyp2p)은 데이터 스트림을 처리하는 자체 방식을 사용하므로 MGT를 훨씬 더 간단하게 사용하며, 이는 이 설계 예제에서 볼 수 있습니다.
MGT마다 내부 구조가 다르기 때문에 MGT PCS 내부의 세부적인 데이터 흐름을 모든 MGT에 적용되는 방식으로 설명하는 것은 불가능합니다. 따라서 아래 설명은 PCS의 기능 블록들이 무엇을 하려는 것인지에 초점을 맞춥니다. PCS와 그 구성 블록에 대한 자세한 설명은 해당 MGT의 문서에서만 찾을 수 있습니다. 아래 설명을 참고하면 그 문서를 읽기가 훨씬 수월할 것입니다.
인코딩과 디코딩
몇 가지 인코딩 방식은 이전 페이지에서 소개했습니다. 8b/10b, 64b/66b, 64b/67b, 128b/130b, 128b/132b가 그것입니다.
8b/10b 구현은 모든 FPGA MGT의 PCS 안에 포함되어 있습니다. 이 구현에는 8비트 워드를 10비트 워드로, 또는 그 반대로 변환하는 인코딩/디코딩 기능뿐만 아니라, 앞 페이지에서 언급한 다른 기능들, 즉 K-심볼(K-symbol), 컴마 심볼(K28.5)에 따른 동기화 및 정렬, 스킵 심볼(K28.0) 대응도 포함됩니다.
다른 인코딩 방식에 관해서는 MGT마다 구현하는 인코딩 세트가 다릅니다. 또한 인코딩의 어떤 기능까지 구현되어 있는지도 MGT마다 다릅니다. 어떤 MGT PCS는 필요한 기어박스만 구현하고, 어떤 MGT는 자동 동기화 메커니즘까지 포함합니다. 표준적인 기능 세트라는 것은 없습니다.
기어박스(Gearboxes)
PCS 전체와 애플리케이션 로직과의 인터페이스에서, 물리 채널의 데이터 스트림은 항상 병렬 워드로 표현됩니다. 이 병렬 워드의 폭은 데이터가 PCS 내부의 여러 처리 단계를 거치면서 달라질 수 있습니다. 예를 들어 데이터가 8b/10b 인코더를 통과하면 워드 폭이 8비트에서 10비트로 바뀝니다.
그런데 애플리케이션 데이터를 MGT로 보내고 MGT에서 받는 인터페이스는 입력 및 출력 포트의 폭이 항상 8의 배수입니다. 일반적으로 이 폭은 16, 32, 40, 64, 80, 128 또는 160비트 중 하나입니다.
그렇다면 예를 들어 64b/66b 인코딩을 사용하면 어떻게 될까요? 이 인코딩에서 물리 채널의 데이터 스트림은 각각 66비트 길이인 세그먼트들로 구성됩니다. 이 데이터를 64비트 폭의 병렬 워드로 표현한다면, 각 세그먼트의 시작점은 매번 그 워드 안에서 다른 위치에 나타납니다. 애플리케이션 로직과의 인터페이스에 허용된 폭 중 어느 것도 이 문제를 피할 수 없습니다.
바로 그런 용도가 기어박스(gearbox)입니다. 기어박스는 입력 포트로 들어오는 데이터를 다른 폭의 병렬 워드로 재구성해 주는 논리 모듈입니다.
예를 들어, 어떤 MGT를 이용해 64b/66b로 인코딩된 데이터를 전송하려 하고, 그 인코더는 애플리케이션 로직에 구현되어 있다고 가정해 봅시다. 인코더의 출력 폭은 66비트인데, MGT의 입력은 64비트 또는 80비트(또는 그보다 덜 관련된 다른 대안)일 수 있습니다. 이 문제를 해결하려면 기존의 병렬 워드(66비트)를 MGT가 받아들일 수 있는 워드(64비트)로 재구성해 주는 기어박스를 구현해야 합니다. 이러한 상황은 피하는 것이 좋습니다.
이런 이유로 MGT는 PCS 부분에 기어박스를 하나 또는 여러 개 포함하는 경우가 많습니다. 특히 MGT에 64b/66b 인코더(또는 128b/130b와 같은 유사한 인코더)가 포함되어 있다면, MGT 내부에 그에 맞는 기어박스도 있습니다. 이렇게 되면 인코딩된 데이터 전송에 필요한 모든 작업을 MGT가 처리합니다. 먼저 데이터가 MGT의 인코더로 인코딩되고, 그다음 기어박스가 병렬 워드의 폭을 바꾸어 Tx PMA로 전송할 수 있게 해 줍니다. 수신 데이터에도 유사한 방식이 사용됩니다.
기어박스 양쪽의 워드가 서로 다르기 때문에 기어박스로 들어가는 비트 수와 기어박스에서 나가는 비트 수는 다릅니다. 입력 병렬 워드가 더 넓으면 기어박스는 그 차이를 보상하기 위해 때때로 워드 수신을 거부해야 합니다. 마찬가지로 출력 병렬 워드가 더 넓으면 기어박스는 항상 출력 포트에 유효한 값을 내보내지는 않습니다. 따라서 기어박스가 클록 하나로만 동작한다면, 양쪽의 비트 수 차이를 보상해 주는 흐름 제어(flow control) 신호도 반드시 있어야 합니다. Xilinx / AMD의 용어로는 이를 동기식 기어박스(synchronous gearbox)라고 합니다.
반면 기어박스는 두 개의 클록에 의존할 수도 있습니다. 이 클록들의 주파수는 기어박스 양쪽의 워드 폭 사이의 비율을 보상하도록 선택됩니다. 이 방식의 장점은 기어박스 어느 쪽에서도 데이터 흐름이 중단되지 않는다는 것입니다. 그러나 이런 기어박스는 두 개의 클록이 필요하고 두 클록 도메인(clock domain)에서 동작합니다. 이 솔루션은 비동기식 기어박스(asynchronous gearbox)라고 합니다.
Tx 버퍼(Tx FIFO)
Tx 버퍼(흔히 Tx FIFO라고도 함)는 Tx PCS 안에 있는 작은 FIFO입니다. 이 FIFO의 깊이(depth)는 보통 16개 또는 32개 데이터 요소이며, 정상 동작 조건에서는 대개 절반가량 차 있습니다. 이 FIFO가 왜 필요한지는 다소 복잡하며 아래에서 설명합니다. 하지만 그 설명은 MGT를 구성할 때 보통 중요하게 여겨지는 유일한 질문, 즉 Tx 버퍼를 활성화할 것인지 여부에 대한 답을 주지는 않습니다.
답은 대부분의 경우 Tx 버퍼를 활성화해야 한다는 것입니다. Tx 버퍼를 사용하지 않아야 하는 유일한 이유는 그것이 유발하는 지연이 문제가 되는 경우입니다. Tx 버퍼를 사용하면 병렬 워드가 MGT로 넘겨진 순간부터 그 워드가 물리 계층에서 전송되는 순간까지의 지연을 정확히 알 수 없습니다. 대부분의 애플리케이션에서 이로 인한 불확실성은 약 0.1μs 정도 또는 그 이하이므로, 프로토콜은 이 지연에 무관심합니다.
이 FIFO가 왜 필요한지에 대한 설명은 다음과 같습니다.
Tx PCS 내부에는 최소 두 개의 클록 도메인이 있습니다. 첫 번째 클록은 애플리케이션 로직과의 인터페이스에 사용됩니다. 두 번째 클록(때로는 XCLK라고도 함)은 Tx PCS가 Tx PMA로 전송할 병렬 워드를 넘겨줄 때 사용됩니다.
MGT 내부의 클로킹(clocking) 주제는 다른 페이지에서 별도로 다룹니다. 지금은 두 개의 별도 클록이 왜 필요한지 이해하는 것만으로 충분합니다. 이를 설명하기 위해 MGT를 일반 SERDES와 비교해 보겠습니다.
예를 들어 일반 출력 핀을 사용하여 1000Mbit/s의 속도로 데이터를 전송하고 싶다고 가정해 봅시다. 오늘날 대부분의 FPGA는 이런 용도로 각 출력 핀에 SERDES가 연결되어 있습니다. 이 예에서는 애플리케이션 로직이 SERDES에 8비트 폭의 병렬 워드를 공급한다고 가정하겠습니다. 따라서 이 병렬 워드의 클록은 125MHz입니다.
그러므로 SERDES에는 두 개의 클록이 공급됩니다. 하나는 125MHz 클록이고, 다른 하나는 500MHz 클록입니다. SERDES는 500MHz 클록의 양쪽 엣지(edge)를 모두 사용하므로 데이터는 원하는 1000Mbit/s 속도로 전송됩니다.
SERDES에 공급되는 두 클록은 정렬되어야 합니다. 예를 들어 500MHz 클록의 상승 엣지가 125MHz 클록의 상승 엣지와 동시에 발생해야 합니다. SERDES가 제대로 동작하려면 이것이 필요합니다. 이러한 정렬은 하나의 PLL로 두 클록을 만들고, 동일한 전파 지연(propagation delay)을 갖는 클록 버퍼를 사용하여 달성됩니다. 이것은 클록을 정렬하는 일반적인 방법입니다. 관련 클록(related clocks)에 대한 설명을 참조하십시오.
그렇다면 5000Mbit/s를 전송하려면 어떻게 해야 할까요? 일반 출력 핀으로는 너무 빠르므로 MGT가 필요합니다. MGT 내부에도 SERDES가 있습니다. 이 SERDES로 들어가는 병렬 워드의 폭이 32비트라고 가정해 보겠습니다. 그러면 이 워드와 연관된 클록 주파수는 156.25MHz입니다. 또한 애플리케이션 로직과의 인터페이스도 32비트 폭의 병렬 워드로 이루어진다고 가정해 보겠습니다. 따라서 이 인터페이스의 클록 주파수도 156.25MHz가 됩니다. 하지만 그것이 같은 클록 신호일까요?
병렬 워드를 전송하려면 MGT의 SERDES가 2500MHz 클록에 연결되어야 합니다(새 비트는 양쪽 클록 엣지에서 전송되므로). 이 주파수는 FPGA의 범용 PLL로는 너무 높습니다. 또한 FPGA의 클록 버퍼나 다른 배선 리소스를 이 클록에 사용하는 것도 불가능합니다. 따라서 MGT에는 SERDES가 필요로 하는 두 개의 정렬된 클록을 생성하기 위한 자체 PLL과 전용 배선이 있어야 합니다. 자세한 내용은 MGT 클로킹에 관한 페이지에서 다룹니다.
이제 Tx PCS 내부에 왜 최소 두 개의 클록 도메인이 필요한지 이해할 수 있습니다. 이 예에서 Tx PCS는 32비트 폭의 병렬 워드를 Tx PMA에 공급합니다. 이 워드의 클록은 156.25MHz입니다. 이 클록은 2500MHz 클록과 정렬되도록 MGT의 PLL로 생성됩니다. 애플리케이션 로직과 MGT 사이의 인터페이스도 정확히 같은 주파수를 사용하지만, 애플리케이션 로직은 그럼에도 같은 클록 신호를 사용할 수 없습니다. 애플리케이션 로직의 클록은 로직 패브릭의 클록 버퍼를 통과해야 하며, 그래야 이 클록이 클록 스큐(clock skew) 없이 모든 로직 요소에 도달할 수 있기 때문입니다. 이 클록 버퍼의 지연 때문에 애플리케이션 로직의 클록은 2500MHz 클록과 자연스럽게 정렬되지 않습니다.
클록 도메인 교차(clock domain crossing)를 처리하는 가장 간단한 방법은 FIFO를 사용하는 것입니다(이 주제를 다루는 페이지에서 언급한 대로). Tx 버퍼가 바로 이 FIFO입니다.
Tx 버퍼를 우회하는 옵션을 제공하는 MGT에는 Tx PCS 내부의 클록 사이에 필요한 정렬을 보장하는 다른 방법도 함께 제공됩니다. 그러나 이러한 방법은 복잡하고 오류가 발생하기 쉽습니다.
Rx 버퍼(Rx FIFO)
Rx 버퍼(흔히 Rx FIFO라고도 함)는 Rx PCS 안에 있는 작은 FIFO입니다. 원칙적으로 이 버퍼는 Tx 버퍼와 같으므로, 위에서 Tx 버퍼에 대해 말한 모든 내용은 Rx 버퍼에도 적용됩니다. 특히 이 버퍼를 활성화할지 여부에 대한 답도 동일합니다. Rx 버퍼는 대부분의 애플리케이션에서 활성화해야 하며, 그것이 유발하는 지연이 허용되지 않는 경우에만 예외입니다.
그러나 Rx 버퍼에는 추가적인 목적이 하나 더 있습니다. Rx PCS가 주파수가 약간 다른 두 클록으로 동작할 수 있게 해 준다는 것입니다. 이제 왜 그런 주파수 차이가 발생할 수 있는지 살펴보겠습니다.
먼저, 이 논의가 데이터 스트림을 수신하는 MGT 부분에 초점을 맞추고 있다는 점을 상기하십시오. 그런데 이 데이터 스트림은 다른 MGT, 즉 (대부분의 시나리오에서) 다른 기준 클록(reference clock)에 의존하는 MGT가 생성한 것입니다. 데이터 스트림을 수신하는 MGT는 대개 송신기가 사용하는 클록에 접근할 수 없습니다. 대신 수신기는 데이터 스트림만을 기반으로 송신기 클록의 복제본을 만듭니다. 이를 가리켜 CDR(Clock Data Recovery, 클록 데이터 복원)이라고 합니다.
그 결과 Rx PMA는 송신기의 데이터 속도에 스스로 적응하는 클록으로 동작합니다. 이 클록의 주파수는 정의된 허용 오차 범위 내에서 불확실합니다. 프로토콜은 항상 주파수가 지정된 값에서 얼마나 벗어날 수 있는지를 정의하지만, 어느 정도의 불확실성은 항상 존재합니다.
따라서 Rx PMA에서 Rx PCS로 병렬 워드를 넘겨주는 인터페이스는 송신기에 적응하는 클록에 의존합니다. Rx PCS는 외부에서 온 클록과 동기화되어야 합니다.
하지만 이것이 Tx PCS와 다른 점은 무엇일까요? Tx 버퍼에 대한 논의에서 기억하듯이 Tx PCS 내부에는 두 개의 클록 도메인이 있습니다. 이 두 클록은 동일한 클록 신호는 아니지만, 동일한 기준 클록을 기반으로 하므로 주파수는 정확히 같습니다.
마찬가지로 Rx PCS 내부에도 두 개의 클록 도메인이 있습니다. 그중 하나의 클록은 주파수를 정확히 알 수 없습니다. 다른 클록은 어떨까요? 답은 애플리케이션 로직의 요구 사항에 달려 있습니다. 대부분의 시나리오에서 MGT는 양방향 프로토콜을 구현하는 데 사용됩니다. 이 프로토콜은 수신된 데이터에 응답하여 데이터를 전송하는 일을 수반합니다. 따라서 애플리케이션 로직 전체가 하나의 클록에 동기화되는 것이 편리합니다. 더 구체적으로 말하면, 가장 일반적인 해법은 모든 애플리케이션 로직이 송신에 사용되는 클록에 동기화되도록 하는 것입니다. 즉, Rx PCS와 애플리케이션 로직 사이의 인터페이스가 Tx PCS와 같은 클록에 동기화된다는 뜻입니다.
이런 방식을 사용하면 Rx PCS 내부의 두 클록은 주파수가 같지 않습니다. 그 결과 Rx PCS는 Rx PMA로부터 데이터를 받는 속도와 그 데이터를 애플리케이션 로직에 넘겨주는 속도가 서로 다릅니다. Rx 버퍼는 이러한 차이를 일시적으로 흡수할 수 있습니다. 애플리케이션 로직이 데이터를 더 느린 속도로 가져가면 Rx 버퍼에 잉여 데이터가 쌓입니다. 애플리케이션 로직이 데이터를 더 빠른 속도로 가져가면 Rx 버퍼의 내용물은 점점 줄어듭니다.
물론 이것은 매우 임시적인 해결책입니다. Rx 버퍼의 채움 수준을 용량의 절반 정도로 유지하기 위한 조치가 없으면, Rx 버퍼는 조만간 오버플로가 발생하거나 완전히 비어 버릴 것입니다. 이를 위한 여러 메커니즘이 있습니다. 예를 들어 앞 페이지에서 기억하듯이 8b/10b 인코딩을 사용하면 클록 주파수 차이를 보상하기 위해 스킵 심볼을 삽입할 수 있습니다. 이 스킵 심볼을 활용하는 메커니즘은 Rx PCS 내부에 구현되어 있습니다. Rx 버퍼가 절반 이상 차 있으면 Rx PCS는 스킵 심볼을 Rx 버퍼에 쓰지 않습니다. 그러면 채움 수준이 낮아집니다. 반대로 Rx 버퍼가 절반보다 덜 차 있으면 Rx PCS는 스킵 심볼을 Rx 버퍼에서 반복해서 읽습니다. 그 결과 버퍼에서 데이터가 빠져나가지 않는 동안 새 데이터가 버퍼를 채우게 됩니다. 따라서 Rx 버퍼의 채움 수준은 높아집니다.
Rx 버퍼는 채움 수준의 차이를 일시적으로 흡수하는 이러한 능력 때문에 종종 탄력 버퍼(elastic buffer)라고 불립니다. 이 능력이 항상 필요한 것은 아니라는 점을 알아 두는 것이 중요합니다. 애플리케이션 로직이 Rx PCS와 인터페이스할 때 Rx PMA의 클록과 주파수가 같은 클록을 사용한다면, Rx 버퍼는 원칙적으로 Tx 버퍼와 동일하게 동작합니다. 이런 방식을 사용할 때, 필요하다면 클록 도메인 교차는 애플리케이션 로직이 직접 구현해야 합니다. 또한 이 방식을 사용하면 필요한 경우 Rx 버퍼를 비활성화할 수도 있습니다(특히 지연을 피하기 위해서). Xillyp2p는 Rx PMA의 클록으로 데이터를 수신하면서도 클로킹을 단순화하기 위해 Rx 버퍼를 사용할 수 있게 하는 애플리케이션 로직의 한 예입니다.
의사 난수 시퀀스 관련 기능
의사 난수 비트 시퀀스(PRBS, Pseudo-Random Bit Sequence)는 무작위처럼 보이지만 실제로는 무작위가 아닌 비트 시퀀스입니다. PRBS는 주기적으로 반복됩니다. 매우 긴 주기(수백만 비트)의 PRBS를 생성하는 것은 쉽기 때문에 PRBS의 통계적 특성은 진정한 무작위 비트 시퀀스와 유사합니다.
PRBS를 생성하는 가장 일반적인 방법은 LFSR(Linear-Feedback Shift Register, 선형 궤환 시프트 레지스터)을 사용하는 것입니다. 이 로직은 몇 개의 플립플롭과 XOR 게이트로 구성되므로 LFSR을 구현하는 데 많은 리소스가 필요하지 않습니다. 널리 사용되는 LFSR의 예는 별도 페이지에서 찾을 수 있는데, 그 페이지는 LFSR과 관련된 수학적 주제를 다룹니다.
MGT의 PCS 부분에는 보통 PRBS와 관련된 몇 가지 기능이 있습니다. 특히 MGT에는 스크램블러(scrambler) 구현이 포함될 수 있습니다. 스크램블러의 동기화가 Rx PCS에 구현되어 있다면 많은 작업을 줄일 수 있습니다.
PRBS의 또 다른 매우 흔한 용도는 물리 채널의 오류를 테스트하는 것입니다. 이 방법은 수신기가 LFSR을 이용해 올바른 비트 시퀀스를 쉽게 생성할 수 있기 때문에 유용합니다. 물리 채널의 오류는 로컬에서 생성된 비트 시퀀스와 수신된 데이터 스트림을 비교하여 검출합니다. 이 메커니즘은 로직 패브릭에 구현하기 어렵지 않지만, 일부 MGT에는 이 기능이 내장되어 있기도 합니다.
안타깝게도 PRBS로 오류 테스트를 수행하는 동안에는 물리 채널을 데이터 전송에 사용할 수 없습니다. 따라서 채널을 실제로 사용하는 동안 그 품질을 모니터링하는 것은 불가능합니다. 일부 프로토콜에는 오류를 보고하는 메커니즘이 있지만, 보통 전송된 데이터에 문제를 일으킨 경우에만 오류가 보고됩니다. 한 가지 예외는 Xillyp2p인데, 링크가 유휴 상태일 때 발생하는 오류도 보고합니다.
이것으로 MGT에 관한 이 시리즈의 네 번째 페이지를 마칩니다. 다음 페이지에서는 PMA와, 까다로운 물리 채널을 보상하는 능력, 그리고 아이 스캐닝(eye scanning)을 수행하는 능력에 대해 논의하기 시작합니다.