이 페이지는 MGT(Multi-Gigabit Transceiver)를 소개하는 페이지 시리즈 중 일곱 번째입니다.
소개
FPGA의 MGT를 구성하는 작업의 대부분이 데이터 처리와 올바른 프로토콜 선택과 관련될 것이라고 기대하는 것은 자연스럽습니다. 따라서 클로킹을 제대로 맞추는 데 그렇게 많은 시간과 노력이 필요하다는 사실은 의외로 다가올 수 있습니다. 이 노력의 대부분은 보통 MGT가 제공하는 클록 리소스와 관련된 다양한 옵션 및 그 옵션들이 부과하는 제약들을 정리하는 데 쓰입니다.
MGT의 클록과 관련된 설계 규칙은 FPGA마다 다르므로, 이 주제에 대한 정확하고 포괄적인 정보를 얻을 수 있는 유일한 신뢰할 만한 출처는 MGT 자체 문서입니다. 그러한 문서는 대개 메커니즘과 그 세부 사항에 초점을 맞추며, 왜 그러한 메커니즘이 필요한지에 대해서는 설명하지 않는 경우가 많습니다. 이 페이지에서는 MGT가 사용하는 클록과 관련된 개념 및 문제점을 다루면서 이러한 공백을 메우고자 합니다.
PLL과 VCO
일반적으로 PLL은 기준 클록(reference clock)의 주파수에 일정한 상수를 곱합니다. 이 상수는 정수일 때도 있고 분수일 수도 있으며 1보다 작을 수도 있습니다. 즉, PLL 출력의 주파수는 기준 클록의 주파수보다 낮을 수 있습니다. MGT에 사용되는 PLL에서는 이런 경우가 드물지만, 로직 패브릭(fabric)용 PLL에서는 유용할 수 있습니다.
FPGA에는 MGT에 필요한 클록을 생성하기 위한 별도의 PLL이 있습니다. 로직 패브릭에 속한 PLL 및 기타 클록 리소스는 MGT에 필요한 주파수를 지원할 수 없습니다. 특히 MGT는 데이터 속도의 절반 이상인 주파수의 클록을 요구합니다. 낮은 데이터 속도의 경우 요구되는 주파수가 더 높을 수도 있습니다.
예를 들어 데이터 속도가 5Gb/s이면 비트 클록은 보통 2.5GHz로 동작합니다. MGT의 SERDES가 클록의 양쪽 엣지(DDR)에서 동작하기 때문입니다. 다만 데이터 속도가 비교적 낮으면 MGT PLL의 출력을 더 낮은 주파수로 분주할 수도 있습니다.
거의 모든 PLL은 동일한 원리로 동작합니다. 핵심 부분은 다양한 주파수의 클록을 생성할 수 있는 VCO(Voltage Controlled Oscillator, 전압 제어 발진기)입니다. VCO의 출력은 주파수를 일정한 숫자로 나누는 클록 분주기로 들어갑니다. 분주기의 출력은 PLL의 기준 클록과 비교됩니다. 제어 메커니즘이 VCO의 주파수를 조정하여 기준 클록과 분주기 출력이 정렬되도록 합니다. 다시 말해, 이 두 신호는 동일한 주파수와 동일한 위상을 갖게 됩니다.
5Gb/s 예로 돌아가서, 기준 클록의 주파수가 125MHz라고 가정해 보겠습니다. PLL을 구현하는 한 가지 방법은 VCO의 출력을 20으로 나누는 것입니다. 분주된 신호는 기준 클록과 비교되어 정렬됩니다. 따라서 VCO의 주파수는 2500MHz여야 합니다. 2500MHz / 20 = 125MHz이기 때문입니다.
이렇게 클록을 만드는 방식은 비트 전송에 적합합니다. 송신 MGT는 각 비트의 시간 구간이 어디서 시작되고 끝나는지를 단독으로 결정합니다. 그러나 MGT가 비트를 수신할 때는 상대편이 각 비트의 타이밍을 결정합니다. 따라서 수신기는 도착하는 데이터 스트림에 적응해야 합니다. 앞 페이지 중 하나에서 언급했듯이, 이러한 적응 메커니즘을 CDR(Clock Data Recovery, 클록 데이터 복원)이라고 합니다. CDR의 구현은 수신기 클록을 도착하는 데이터 스트림에 동기화하기 위해 VCO의 주파수를 조정하는 제어 루프로 구성됩니다. 기준 클록은 VCO를 기대 주파수에 충분히 가까운 초기 주파수로 설정하기 위해 가끔 사용됩니다. 일단 동기화가 이루어진 후에는 기준 클록은 무시됩니다.
PLL 활용
FPGA 내부의 MGT용 PLL은 복잡한 주제입니다. 각 MGT는 하나 이상의 PLL에서 클록을 받을 수 있습니다. FPGA 프로젝트에서 MGT를 사용하는 애플리케이션이 하나뿐이라면, 툴이 보통 가장 적합한 PLL을 자동으로 선택합니다. 그러나 프로젝트에서 MGT들을 서로 다른 용도로 사용한다면, 각 MGT가 가장 적합한 PLL에 연결되도록 하는 것이 중요합니다.
FPGA에는 대개 여러 MGT가 공유하는 PLL이 있습니다. AMD(Xilinx)는 이를 QPLL이라고 부르고, Altera에는 fPLL과 ATX PLL이 있습니다. 반면 특정 MGT 하나에 전용으로 연결되는 PLL도 있습니다. 이것은 CPLL(AMD / Xilinx) 또는 CMU PLL(Altera)이라고 부릅니다. 로컬 PLL은 보통 공유 PLL에 비해 품질이 낮고 기능도 적습니다. 주파수 범위, 지터(jitter), 그리고 기준 클록에 대해 선택할 수 있는 체배 비율에서 차이가 있을 수 있습니다.
각 FPGA에는 PLL과 MGT를 어떻게 서로 연결할 수 있는지를 규정하는 복잡한 규칙들이 있습니다. 이 규칙들은 PLL을 FPGA의 기준 클록 입력에 연결하는 가능성도 정의합니다. 따라서 모든 MGT가 필요로 하는 클록에 연결될 수 있다고 당연히 여겨서는 안 됩니다. 이것은 거의 제약이 없는 로직 패브릭의 클록과는 매우 다릅니다.
그러므로 각 MGT에 어떤 PLL을 선택할지 결정하기 전에 데이터시트를 꼼꼼히 읽어 보는 것이 좋습니다. 특히 PCB를 설계할 때 모든 MGT에 필요한 클록을 공급할 수 있는지 확인하는 것이 중요합니다. 필요한 모든 MGT가 포함된 FPGA 프로젝트를 만들고, 그 프로젝트의 구현이 성공적으로 완료되며 모든 핀이 올바른 위치에 배치되었는지 확인하면 됩니다.
기준 클록
FPGA에는 MGT의 PLL용으로 마련된 기준 클록 전용 핀이 따로 있습니다. PCB 설계에서는 기준 클록 입력을 해당 클록을 사용하려는 MGT와 함께 사용할 수 있는지 확인하는 것이 중요합니다. 기준 클록 입력, PLL, MGT 사이의 상호 연결은 가능한 모든 조합을 허용하지 않습니다. 허용되는 조합은 FPGA 문서에 나와 있지만, 규칙이 복잡해서 확정적인 결론을 내리기 어려울 수 있습니다. FPGA 프로젝트를 통해 필요한 내용이 충족되는지 확인하는 것이 더 나은 경우가 많습니다.
이 용도로 사용되는 클록은 정확도가 높고 지터(jitter)가 낮은 고품질이어야 합니다. 범용 클록 칩에서 생성된 클록을 연결하는 것은 흔한 실수입니다. 그렇게 하면 MGT의 성능이 저하될 가능성이 높으며, 신호 무결성 문제나 데이터 전선에 추가된 노이즈처럼 보이는 오류가 발생할 수 있습니다.
MGT가 특정 프로토콜(예: PCIe, SuperSpeed USB 또는 SATA)용으로 사용된다면, 기준 클록 요구 사항에 대한 FPGA 제조사의 문서를 읽어 보는 것이 좋습니다. '저지터 클록 소스(low-jitter clock source)'라고 표시된 전자 부품이라도 충분하지 않을 수 있습니다.
지터는 무작위 과정입니다. 지터의 크기는 중요한 매개변수이지만 항상 충분한 정보를 주는 것은 아닙니다. 클록 지터의 무작위성은 클록 주기의 빠른 변화를 일으킬 수도 있고, 느린 변화를 일으킬 수도 있습니다. 지터가 이런 면에서 어떻게 동작하는지는 지터의 노이즈 스펙트럼에서 유추할 수 있습니다.
클록을 생성하는 부품의 데이터시트에는 때때로 지터의 크기(보통 피코초 단위)만 숫자로 나와 있습니다. 지터의 노이즈 스펙트럼 정보는 제공되지 않는 경우가 많습니다. 특히 지터의 크기가 어차피 매우 낮다면, 이런 정보가 없어도 해당 부품이 충분히 적합할 수 있습니다.
이 질문에는 간단한 답이 없는 경우가 많습니다. 그럼에도 기준 클록의 품질은 MGT를 어떤 용도로 사용하든 중요합니다. 잘 알려진 프로토콜들의 요구 사항은 어떤 프로젝트에서든 좋은 참고 기준이 됩니다. 개발 보드에서 기준 클록으로 사용되는 부품들과 비교해 보는 것도 유용합니다.
로직 패브릭용 클록
MGT와 로직 패브릭 사이의 인터페이스에 사용되는 클록은 MGT 자체 PLL에서 생성됩니다. 이것은 필수적입니다. PMA 내부에서는 SERDES가 두 개의 클록에 의존하기 때문입니다. 물리 채널의 비트에 대응하는 클록과 병렬 워드와 함께 사용되는 클록이 그것입니다. SERDES가 제대로 동작하려면 이 두 클록이 PMA 내부에서 정렬되어야 합니다.
한편, 로직 패브릭에서 사용되는 모든 클록은 낮은 클록 스큐(clock skew)를 보장하는 방식으로 분배되어야 합니다. 이를 위해 툴은 보통 글로벌 클록 버퍼를 선택합니다. 클록 버퍼에서 모든 로직 요소까지의 전파 지연(propagation delay)은 거의 같기 때문에, 클록 엣지는 모든 목적지에 동시에 도달합니다. 이것은 툴이 로직 패브릭에 대해 올바른 타이밍 계산을 수행할 수 있게 해 주는 필수 조건입니다.
이 전파 지연이 모든 배선에서 동일하더라도 반드시 작은 것은 아닙니다. 오히려 FPGA 내부에서 클록 버퍼를 목적지에 연결하는 배선은 상당한 지연을 추가합니다. 모든 연결들 사이의 차이가 작기 때문에 이것은 보통 문제가 되지 않습니다.
하지만 이 지연 때문에 PMA가 사용하는 두 클록은 로직 패브릭의 클록과 정렬되지 않게 됩니다. 이 세 클록 중 하나는 주파수가 너무 높기 때문에 로직 패브릭의 리소스만으로는 이들을 정렬하는 것이 불가능합니다. 그런데도 MGT와 로직 패브릭은 양쪽이 동기화할 수 있는 공통 클록이 필요합니다. 유일한 해결책은 클록 신호를 하나 더 추가하는 것입니다.
이것은 결국 각 방향마다 최소한 세 개의 클록 신호가 필요하다는 뜻입니다.
- 물리 채널의 비트와 동기화된 클록: 이 클록의 주파수는 보통 데이터 속도의 절반입니다(위 예에서는 2.5GHz).
- PMA 내부의 병렬 워드와 동기화된 클록: 이 클록은 때때로 XCLK라고 부릅니다. 예를 들어, PMA가 PCS와 32비트 폭의 병렬 워드로 인터페이스한다면, 이 클록의 주파수는 156.25MHz입니다(5000 / 32 = 156.25이므로).
- 로직 패브릭의 클록: MGT와 로직 패브릭 사이의 인터페이스에서 사용되는 클록입니다. 이 클록은 보통 TXUSRCLK2, RXUSRCLK2, tx_coreclkin, rx_coreclkin 등과 같은 이름을 갖습니다(아래 다이어그램에서는 'Tx user clock' 및 'Rx user clock'으로 표시됨). 이 클록의 주파수는 로직 패브릭과 인터페이스하는 데 사용되는 병렬 워드의 폭에 따라 달라집니다.
일반적으로 송신과 수신에는 각각 별도의 클록이 있다는 점에 유의하십시오. 아래 블록 다이어그램은 MGT 내부에서 클록이 일반적으로 어떻게 분배되는지 보여 줍니다.
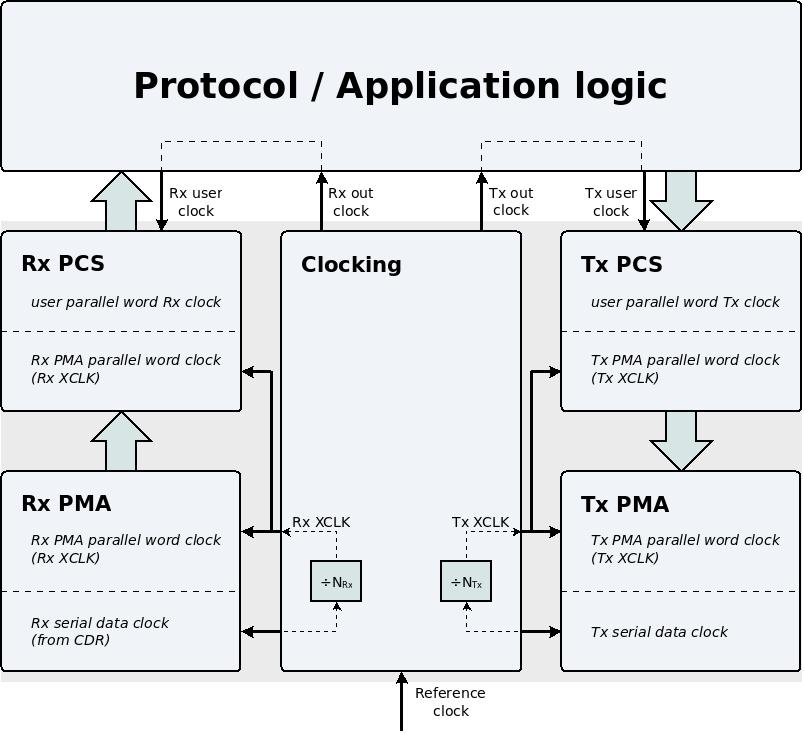
이 블록 다이어그램에는 각 방향에 대해 위에서 언급한 세 개가 아니라 네 개의 클록이 있습니다. 이것은 다음 절에서 설명합니다.
로직 패브릭 클록 생성
위에서 설명했듯이, 로직 패브릭과 MGT가 공통으로 사용하는 클록은 로직 패브릭의 클록 버퍼를 통해 분배되어야 합니다. 반면 이 클록은 MGT 내부에서 생성되어야 합니다.
이렇게 상충되는 두 요구 사항에 대한 가장 간단한 해결책부터 살펴보겠습니다. MGT가 실제로 클록을 생성하여 출력 포트로 내보내는 것입니다. 이 출력 포트는 보통 TXOUTCLK, RXOUTCLK, tx_clkout, rx_clkout 등으로 불립니다(위 다이어그램의 네 번째 클록이며, 'Tx out clock' 및 'Rx out clock'으로 표시됨). 이 신호는 로직 패브릭 클록 버퍼의 입력으로 들어갑니다. 이 클록 버퍼의 출력이 MGT와 로직 패브릭 사이의 인터페이스에 사용되는 클록 신호입니다.
이렇게 구성하면 로직 패브릭의 클록과 MGT가 생성한 클록 사이의 유일한 차이는 클록 버퍼의 전파 지연뿐입니다. 즉, MGT는 위상을 제외하고는 로직 패브릭의 클록을 완전히 제어할 수 있습니다. 이것은 특히 데이터를 수신할 때 중요합니다. CDR의 클록을 로직 패브릭과의 인터페이스 기준으로 사용한다면 더욱 그렇습니다(이 옵션은 아래에서 논의합니다). CDR은 도착하는 데이터 스트림과 동기화를 유지하기 위해 이 클록의 주파수를 계속 조정하기 때문입니다.
앞 페이지에서 논의했듯이, PCS는 로직 패브릭 클록과 PMA 클록 사이의 위상 차이를 극복하기 위한 메커니즘을 제공합니다. Tx 버퍼나 Rx 버퍼가 가장 쉬운 선택이지만, PCS가 이 차이를 직접 조정하는 기능을 갖추고 있을 수도 있습니다.
그렇다면 MGT의 클록 출력 포트에는 어떤 클록이 나타날까요? 자연스러운 답은 XCLK입니다. 바로 이 클록이 로직 패브릭 클록의 요구 사항에 가장 가까운 후보이기 때문입니다. 하지만 로직 패브릭 클록을 생성하는 방법은 이것 외에도 여러 가지가 있습니다. 예를 들어, MGT의 클록 출력을 일반 로직 패브릭 PLL에 공급하여 다른 주파수의 클록을 생성할 수 있습니다. 이 PLL은 클록 버퍼와 함께 사용되므로, 그 결과로 생기는 클록 신호는 목적에 적합합니다. 이렇게 PLL을 사용하면 새로운 가능성이 생깁니다. 예를 들어 MGT가 자신의 기준 클록을 클록 출력 포트로 그대로 통과시킬 수 있습니다. 이 클록의 주파수는 MGT와의 인터페이스에 사용하기에는 맞지 않을 수 있지만, PLL이 이 클록을 필요한 비율로 체배하면 됩니다.
또한 로직 패브릭 클록의 주파수가 XCLK의 주파수와 다를 수 있다는 점에도 유의하십시오. PCS 내부에서 비동기식 기어박스(asynchronous gearbox)가 활성화되면 이렇게 해야 할 수 있습니다. 이 시나리오에서는 PMA와 로직 패브릭 인터페이스에서 사용되는 병렬 워드의 폭 차이를 보상하기 위해 주파수 차이가 필요합니다.
이 주제와 관련된 규칙은 복잡하며 FPGA마다 다릅니다. MGT 문서의 상당 부분이 다양한 가능성을 자세히 설명하는 데 할애되는 경우가 많습니다. 안타깝게도 클로킹에 대해 올바른 결정을 내리려면 해당 FPGA에 적용되는 규칙을 익히는 데 시간을 투자해야 합니다.
수신 데이터용 로직 패브릭 클록 선택
데이터 수신에 사용할 로직 패브릭 클록을 생성하는 방법을 선택할 때는 근본적인 결정이 필요합니다. 이 클록을 CDR의 클록에서 파생시킬지, 아니면 고정된 기준 클록에서 파생시킬지가 바로 그것입니다. 다시 말해, 로직 패브릭의 클록이 도착하는 데이터 스트림의 정확한 데이터 속도에 맞춰지는지, 그렇지 않은지의 문제입니다.
대부분의 애플리케이션에서 MGT는 양방향 데이터 통신에 사용됩니다. 도착하는 데이터와 전송하는 데이터 사이에는 밀접한 관계가 있는 경우가 많습니다. 예를 들어, 전송되는 데이터 스트림에는 도착하는 데이터 스트림에 대한 응답으로 보내는 확인 응답(acknowledgement)이나 재전송 요청이 포함될 수 있습니다. 이런 애플리케이션에서는 모든 로직이 동일한 클록에 동기화되는 것이 편리합니다(즉, 모든 로직이 같은 클록 도메인(clock domain)에 있는 것). 특히 PIPE 인터페이스는 MGT와의 모든 인터페이스가 하나의 클록(표준 문서에서 PCLK라고 부름)에 동기화될 것을 요구합니다. 앞서 PIPE가 MGT와 PCIe, SuperSpeed USB, SATA 같은 여러 프로토콜 사이의 표준 인터페이스라는 점을 기억하십시오.
하지만 이런 편리함에는 대가가 따릅니다. 로직 패브릭 클록의 주파수는 PMA의 병렬 워드에 사용되는 주파수, 즉 XCLK의 주파수와 잠재적으로 약간 다릅니다. 로직 패브릭이 PMA에 병렬 워드가 도착하는 속도보다 느리거나 빠르게 병렬 워드를 가져가기 때문에, 이 차이는 PCS 내부에 데이터의 잉여나 부족을 일으킵니다. 이 문제의 해결책은 PCS에 관한 페이지에서 논의한 것처럼 Rx 버퍼와 스킵 심볼을 사용하는 것입니다.
대안으로, 로직 패브릭 클록을 PMA의 클록에서 파생시킬 수도 있습니다. 이 방법을 사용하면 로직 패브릭은 데이터가 도착하는 것과 같은 속도로 데이터를 소비합니다. MGT가 수신 전용으로 사용될 때는 이것이 자연스러운 해결책입니다. 애플리케이션 로직이 클록 도메인 교차(clock domain crossing)를 처리한다면 양방향 링크에서도 선택할 수 있는 방법입니다. Xillyp2p는 이런 접근 방식을 채택한 프로토콜의 예이며, 해당 완전한 설계 예제에서 확인할 수 있습니다.
AMD FPGA: 로직 패브릭에서 받는 두 개의 클록
AMD(이전 Xilinx) FPGA의 MGT에는 로직 패브릭에서 입력되는 클록 포트가 각 방향당 두 개씩 있습니다. 즉, 송신에는 TXUSRCLK와 TXUSRCLK2가, 수신에는 RXUSRCLK와 RXUSRCLK2가 사용됩니다. MGT의 인스턴스화(instantiation) 예는 이 설계 예제에 나와 있습니다.
로직 패브릭과의 인터페이스는 거의 모두 TXUSRCLK2 또는 RXUSRCLK2(방향에 따라 다름)에 동기화됩니다. TXUSRCLK와 RXUSRCLK는 다른 두 입력으로, PCS의 일부 부분에서 내부적으로만 사용됩니다.
TXUSRCLK는 흔히 TXUSRCLK2와 동일한 클록 신호입니다. 다만 AMD FPGA의 MGT에는 로직 패브릭과 인터페이스할 때 사용하는 병렬 워드를 PCS 내부보다 두 배 넓게 쓸 수 있는 기능이 있습니다. 이 기능을 사용하면 TXUSRCLK의 주파수는 TXUSRCLK2 주파수의 두 배가 됩니다. 이것은 로직 패브릭 PLL을 사용해야 하는 또 하나의 이유입니다.
동일한 원리가 RXUSRCLK와 RXUSRCLK2에도 적용됩니다.
요약
이 페이지에서는 MGT의 클록과 관련된 몇 가지 주제를 간략히 살펴보았습니다. 그렇지만 MGT의 클로킹 리소스를 현명하게 활용하려면 MGT의 고유한 기능과 한계를 익히는 것이 필요합니다. 이 페이지의 설명이 MGT의 클록들이 어떻게 동작하고 서로 어떻게 상호 작용하는지 이해하는 데 도움이 되기를 바랍니다.
이것으로 MGT에 관한 이 시리즈의 일곱 번째 페이지를 마칩니다. 다음 페이지에서는 흐름 제어(flow control)에 대한 논의로 이 시리즈를 마무리합니다.