このページは、マルチギガビット・トランシーバ(MGT)を紹介する一連のページの 4 ページ目です。前のページでは、MGT と、それに使われるいくつかのプロトコル、およびいくつかのエンコーディング方式について説明しました。
はじめに
このシリーズの最初のページで述べたように、MGT は一種の高機能な SERDES にすぎません。MGT を高機能にしている理由はいくつかありますが、特定のプロトコルの実装に役立つ構成ブロックが MGT 内部にいくつかあることもその 1 つです。このページでは、これらの構成ブロックのいくつかが存在する理由を説明します。
これらのユニットを含む MGT の部分は、通常 PCS(Physical Coding Sublayer、物理符号化副層)と呼ばれます。ただし、この名前は誤解を招く可能性があります。PCS 内部のロジックの一部は、エンコードにもデコードにも関係がないからです。
以下は、一般的な MGT のブロック図で、より大きな全体像の中で PCS がどこに位置するかを示しています。
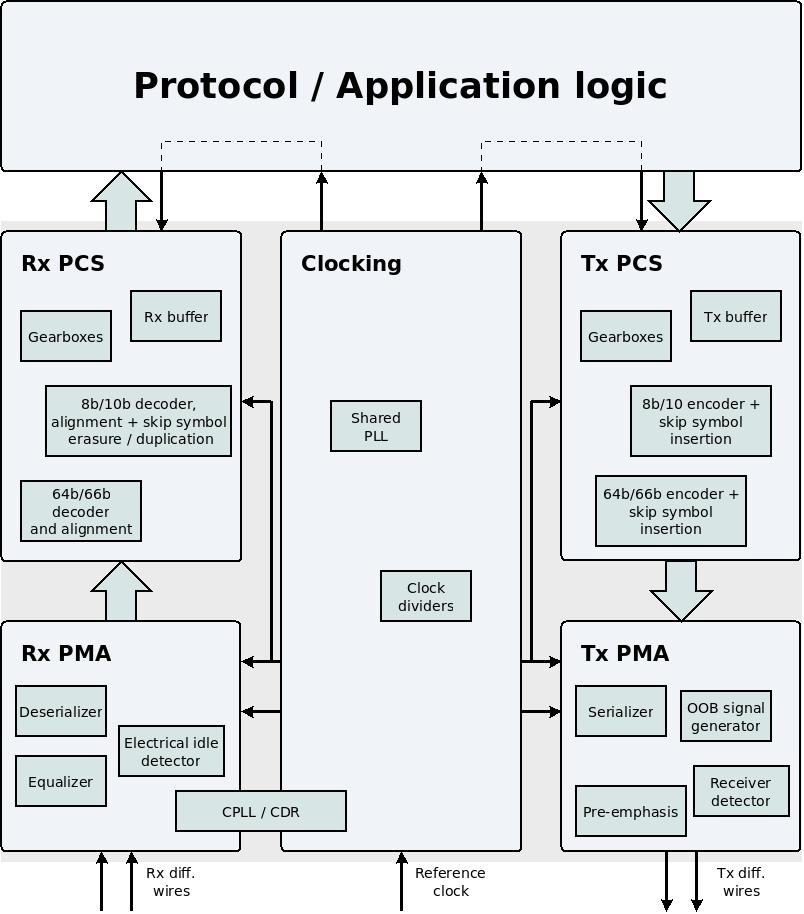
PCS は、PMA とユーザー側のアプリケーションロジック(application logic)の間にあるすべてのものです。本稿では、データ送信に使われる MGT 内の部分を指すために「Tx PMA」および「Tx PCS」という表現を使います。同様に、データ受信に使われる部分を指すために「Rx PMA」および「Rx PCS」という表現を使います。
Tx PCS は、送信データをアプリケーションロジックが MGT へ渡す入力ポートから始まります。Tx PCS の役割は、物理配線上で送信できる状態になったビット群からなるパラレルワードが得られた時点で終わります。このパラレルワードは、シリアライズして電気信号に変換するために Tx PMA 部分へ渡されます。
同様に、Rx PCS は、Rx PMA が受信してデシリアライズしたデータのパラレルワードから始まり、MGT がデータをアプリケーションロジックへ渡す出力ポートで終わります。
PCS はパラレルワードに対してのみ動作するロジックで構成されているため、PCS の機能はすべてロジックファブリック(logic fabric)に実装できることは明らかです。それでも、このロジックが MGT 内部に実装されているのは、多くの構成ブロックがハード IP(hard IP)として実装されるのと同じ理由によります。一部のプロトコルは PCS のエンコーディング機能を活用します。一方、他のプロトコル(例:Xillyp2p)はデータストリームを処理する独自の方法に依存しており、このサンプルデザインに示すように、MGT の使い方自体をはるかに単純にしています。
MGT はそれぞれ内部構造が異なるため、すべての MGT に当てはまる形で、MGT の PCS 内部の詳細なデータフローを説明することは不可能です。そこで、以下の説明では、PCS の各機能ブロックが何を達成しようとしているかに焦点を当てます。PCS とその構成ブロックの詳細な説明は、各 MGT のドキュメントにしかありません。以下の説明があれば、そのドキュメントを読むのがより容易になるでしょう。
エンコーディングとデコーディング
前のページでは、8b/10b、64b/66b、64b/67b、128b/130b、128b/132b といういくつかのエンコーディング方式を紹介しました。
8b/10b の実装は、すべての FPGA MGT の PCS に含まれています。この実装には、8 ビットワードを 10 ビットワードへ(あるいはその逆へ)変換するエンコード/デコードに加え、前のページで述べた他の機能も含まれます。K シンボル、コンマシンボル(K28.5)に応じた同期とアライメント、スキップシンボル(K28.0)への対応などです。
他のエンコーディング方式については、MGT ごとに実装しているエンコーディングのセットが異なります。また、エンコーディングのどの機能を実装するかも MGT によって異なります。MGT の PCS が必要なギアボックス(gearbox)だけを実装している場合もあれば、自動同期のメカニズムも含まれている場合もあります。標準的な機能セットというものはありません。
ギアボックス
PCS 全体でも、アプリケーションロジックとのインターフェースでも、物理チャネル上のデータストリームはパラレルワードで表現されます。このパラレルワードの幅は、データが PCS 内のさまざまな処理段階を通過するにつれて変わることがあります。例えば、データが 8b/10b エンコーダを通過すると、ワード幅は 8 ビットから 10 ビットに変わります。
ただし、MGT との間でアプリケーションデータをやり取りするインターフェースの入力ポートと出力ポートの幅は、常に 8 の倍数です。通常、この幅は 16、32、40、64、80、128、160 ビットのいずれかです。
しかし、例えば 64b/66b エンコーディングを使う場合はどうなるでしょうか。このエンコーディングでは、物理チャネル上のデータストリームは、それぞれ 66 ビット長のセグメントで構成されます。このデータを幅 64 ビットのパラレルワードで表すと、各セグメントの先頭が、ワード内の毎回異なる位置に現れることになります。アプリケーションロジックとのインターフェースで許容される幅のうち、この問題を回避できるものはありません。
これがギアボックスの目的です。入力ポートに到着したデータを、異なる幅のパラレルワードに再構成するロジックモジュールです。
例えば、MGT を使って 64b/66b でエンコードされたデータを送信したいとします。そして、エンコーダはアプリケーションロジックに実装されているとします。エンコーダの出力は 66 ビット幅ですが、MGT の入力が受け付けられる幅は 64 ビットまたは 80 ビットです(あるいは、さらに当てはまりの悪い他の幅もあります)。これを解決するには、既存のパラレルワード(66 ビット幅)を、MGT が受け入れられるワード(64 ビット幅)へ再構成するギアボックスを実装する必要があります。これは避けたほうがよい状況です。
このため、MGT の PCS 部分には、1 つまたは複数のギアボックスが含まれていることがよくあります。特に、MGT が 64b/66b エンコーダ(128b/130b などの類似のエンコーダ)を内蔵している場合は、MGT 内部に適切なギアボックスもあります。こうして MGT は、エンコードされたデータの送信に必要なすべてのタスクを処理します。まずエンコーダでデータがエンコードされ、次にギアボックスがパラレルワードの幅を変換して、そのワードを送信のために Tx PMA 部分へ渡せるようにするのです。受信側でも同様の仕組みが使われます。
ギアボックスは両側でワード幅が異なるため、ギアボックスに入るビット数と出て行くビット数は異なります。入力側のパラレルワードが広い場合、ギアボックスはその差を補うために、時々ワードの受け取りを拒否しなければなりません。同様に、出力側のパラレルワードが広い場合、出力ポートに常に有効なデータが用意されているとは限りません。したがって、ギアボックスが 1 つのクロックだけを使って動作する場合、両側のビット数の違いを補うフロー制御(flow control)信号も必要です。Xilinx / AMD の用語では、これは同期ギアボックス(synchronous gearbox)と呼ばれます。
もう 1 つの方法として、ギアボックスを 2 つのクロックに依存させることもできます。これらのクロックの周波数は、ギアボックスの両側のワード幅の比を補償するように選ばれます。この方法の利点は、ギアボックスのどちらの側でもデータフローが止まらないことです。ただし、この種のギアボックスは 2 つのクロックを必要とし、2 つのクロックドメイン(clock domain)で動作します。この解決策は非同期ギアボックス(asynchronous gearbox)と呼ばれます。
Tx バッファ(Tx FIFO)
Tx バッファ(Tx FIFO と呼ばれることも多い)は、Tx PCS 内にある小さな FIFO です。この FIFO の深さは通常 16 または 32 データ要素で、通常の動作状態ではおおよそ半分までデータが入っています。この FIFO が必要になる理由はやや込み入っているので、以下で説明します。ただし、その説明は、MGT を設定するときに通常問題となる唯一の疑問には答えません。Tx バッファを有効にすべきかどうか、という疑問です。
答えは、ほとんどの場合、Tx バッファを有効にすべきだ、というものです。Tx バッファの使用を避ける唯一の理由は、その遅延が問題を引き起こす場合です。Tx バッファを使うと、パラレルワードを MGT に渡した瞬間から、そのワードが物理層で送信される瞬間までの遅延が不明になります。ほとんどのアプリケーションでは、この不確かさはおよそ 0.1μs 以下程度なので、プロトコルはこの遅延を問題にしません。
この FIFO がなぜ必要なのかについては、以下で説明します。
Tx PCS の中には、少なくとも 2 つのクロックドメインがあります。最初のクロックはアプリケーションロジックとのインターフェースに使われます。2 番目のクロック(XCLK と呼ばれることもあります)は、Tx PCS が送信用のパラレルワードを Tx PMA へ渡す箇所で使われます。
MGT 内部のクロッキングの話題は、別のページで個別に説明します。ここでは、なぜ 2 つの独立したクロックが必要なのかを理解すれば十分です。これを説明するために、MGT を通常の SERDES と比較してみましょう。
例えば、通常の出力ピンを使って 1000 Mbits/s のデータレートで送信したいとしましょう。今日のほとんどの FPGA には、この目的のために各出力ピンに SERDES が接続されています。この例では、アプリケーションロジックが 8 ビット幅のパラレルワードを SERDES に供給すると仮定します。したがって、このパラレルワードのクロックは 125 MHz です。
これに応じて、SERDES には 2 つのクロックが供給されます。1 つは 125 MHz のクロック、もう 1 つは周波数 500 MHz のクロックです。SERDES は 500 MHz クロックの両エッジを使うので、データは目標の 1000 Mbits/s で送信されます。
SERDES に入力される 2 つのクロックは、互いにアライメントされている必要があります。例えば、500 MHz クロックの立ち上がりエッジは、125 MHz クロックの立ち上がりエッジと同時でなければなりません。これは SERDES が正しく動作するために必要です。このアライメントは、両方のクロックを 1 つの PLL で生成し、同じ伝搬遅延(propagation delay)を持つクロックバッファを使うことで実現されます。これはクロックをアライメントするための一般的な方法です。関連クロック(related clocks)についての説明を参照してください。
では、5000 Mbits/s を送りたい場合はどうでしょうか。これは通常の出力ピンでは処理できないため、MGT が必要です。MGT の中にも SERDES があります。この SERDES に入るパラレルワードの幅が 32 ビットだとしましょう。すると、このワードに付随するクロックの周波数は 156.25 MHz です。また、アプリケーションロジックとのインターフェースも 32 ビット幅のパラレルワードで構成されていると仮定しましょう。すると、このインターフェースのクロック周波数も同じ 156.25 MHz です。しかし、それは同じクロック信号でしょうか?
パラレルワードを送信するには、MGT の SERDES は 2500 MHz のクロックに接続されなければなりません(新しいビットはクロックの両エッジで送信されます)。この周波数は、FPGA の汎用 PLL には高すぎます。また、FPGA のクロックバッファやその他の配線リソースをこのクロックに使うこともできません。したがって、MGT は、SERDES が必要とする 2 つのアライメントされたクロックを生成するために、独自の PLL と配線を持っていなければなりません。詳細は、MGT のクロッキングのページを参照してください。
これで、Tx PCS の中に少なくとも 2 つのクロックドメインがある理由を理解する準備ができました。この例では、Tx PCS は幅 32 ビットのパラレルワードを Tx PMA に供給します。このワードのクロックは 156.25 MHz です。このクロックは、2500 MHz クロックとのアライメントを確保するために、MGT の PLL によって生成されます。アプリケーションロジックと MGT のインターフェースはまったく同じクロック周波数に基づいていますが、それにもかかわらずアプリケーションロジックは同じクロック信号を使えません。アプリケーションロジックのクロックは、ロジックファブリックのクロックバッファを通過して、すべての論理要素にクロックスキュー(clock skew)なしで到達する必要があるからです。このクロックバッファの遅延のため、アプリケーションロジックのクロックは 2500 MHz クロックと自然にはアライメントされません。
クロックドメイン交差(clock domain crossing)の最も簡単な方法は、FIFO を使うことです(このトピックを扱うページで述べたとおりです)。Tx バッファはこの FIFO です。
Tx バッファをバイパスするオプションを提供する MGT には、Tx PCS 内部のクロック間で必要なアライメントを確保するための他の方法も用意されています。ただし、これらの方法は複雑で、間違いが起こりやすいものです。
Rx バッファ(Rx FIFO)
Rx バッファ(Rx FIFO と呼ばれることも多い)は、Rx PCS 内にある小さな FIFO です。原理的には、このバッファは Tx バッファと同じなので、上記で Tx バッファについて述べたことは Rx バッファにも当てはまります。特に、このバッファを有効にすべきかという答えも同じです。Rx バッファは、それが引き起こす遅延が許容できない場合を除き、ほとんどのアプリケーションで有効にすべきです。
ただし、Rx バッファにはもう 1 つの目的があります。Rx PCS が、周波数がわずかに異なる 2 つのクロックで動作できるようにすることです。ここでは、なぜそのような差が生じ得るのかを説明します。
まず、ここでの議論が、データストリームを受信する MGT の部分に焦点を当てていることを確認しておきましょう。このデータストリームは別の MGT によって生成されたものであり、その MGT は(ほとんどのシナリオでは)別の基準クロックに依存しています。データストリームを受信する MGT は、送信側が使っているクロックにアクセスできないことがよくあります。その代わり、受信側はデータストリームだけに基づいて、このクロックの複製を作り出します(これは CDR(Clock Data Recovery、クロックデータリカバリ)と呼ばれます)。
その結果、Rx PMA は、送信側のデータレートに適応するクロックで動作します。このクロックの周波数は、決められた許容範囲内で不確かです。プロトコルは、周波数が規定値からどれだけずれてよいかを常に定義していますが、それでも常にある程度の不確かさは残ります。
したがって、Rx PMA から Rx PCS へパラレルワードを渡すインターフェースは、送信側に適応するクロックに依存しています。Rx PCS は、外部由来のクロックと同期しなければなりません。
しかし、これは Tx PCS とどこが違うのでしょうか。Tx バッファに関する説明を思い出してください。Tx PCS の部分には 2 つのクロックドメインがありました。これら 2 つのクロックは同じクロック信号ではありませんが、同じ基準クロックに基づいているため、周波数は完全に同じです。
同様に、Rx PCS の部分にも 2 つのクロックドメインがあります。一方のクロックの周波数は不明です。もう一方のクロックはどうでしょうか。答えは、アプリケーションロジックの要件次第です。ほとんどのシナリオでは、MGT は双方向プロトコルの実装に使われます。このプロトコルでは、受信したデータに応答してデータを送信するという動作が含まれます。したがって、アプリケーションロジック全体を 1 つのクロックに同期させると便利です。より具体的には、最も一般的な解決策は、アプリケーションロジック全体を送信に使うクロックに同期させることです。これは、Rx PCS とアプリケーションロジックとのインターフェースが、Tx PCS と同じクロックに同期していることを意味します。
この方法を採ると、Rx PCS 内部の 2 つのクロックの周波数は同じではなくなります。その結果、Rx PCS が Rx PMA からデータを受け取る速度と、そのデータをアプリケーションロジックへ渡す速度が異なります。Rx バッファはこの差を一時的に吸収できます。アプリケーションロジックがデータを取り出す速度が遅ければ、Rx バッファに余剰なデータが蓄積されます。アプリケーションロジックがデータを取り出す速度が速ければ、Rx バッファは徐々に empty(空)になっていきます。
もちろん、これはあくまで一時しのぎの解決策です。Rx バッファの使用量を容量の約半分に保つための何らかの対策をしない限り、Rx バッファは遅かれ早かれオーバーフロー(overflow)するか、empty(空)になります。この目的には、さまざまなメカニズムがあります。例えば、前のページで述べたように、8b/10b エンコーディングを使う場合、クロック周波数の差を補償するためにスキップシンボルを挿入できます。スキップシンボルを活用するメカニズムは、Rx PCS 内に実装されています。Rx バッファの充填レベルが半分より多い場合、Rx PCS はスキップシンボルを Rx バッファに書き込みません。これにより充填レベルが下がります。逆に、Rx バッファの充填レベルが半分より少ない場合、Rx PCS は Rx バッファからスキップシンボルを繰り返し読み出します。その結果、バッファからデータが排出されない一方で、新しいデータがバッファを満たしていきます。したがって、Rx バッファの充填レベルは上昇します。
Rx バッファは、充填レベルの差を一時的に吸収できることから、エラスティックバッファ(elastic buffer)と呼ばれることがよくあります。この機能が常に必要というわけではない点に注意が重要です。アプリケーションロジックが、Rx PMA のクロックと同じ周波数のクロックで Rx PCS とやり取りする場合、Rx バッファは原理的には Tx バッファと同じように動作します。この方法を採る場合、必要であればクロックドメイン交差を実装するのはアプリケーションロジックの責任です。また、この方法では、必要に応じて(特に遅延を避けるために)Rx バッファを無効にすることもできます。Xillyp2p は、Rx PMA のクロックでデータを受信するアプリケーションロジックの例ですが、クロッキングを簡素化するために Rx バッファを使用することもできます。
擬似ランダム系列(PRBS)に関連する機能
擬似ランダムビット系列(PRBS、Pseudo-Random Bit Sequence)は、ランダムに見えるビット列ですが、実際にはランダムではありません。PRBS は周期的に繰り返します。PRBS は数百万ビットといった非常に長い周期でも容易に生成できるため、その統計的性質は、真のランダムビット列の性質に近くなります。
PRBS を生成する最も一般的な方法は、LFSR(Linear-Feedback Shift Register、線形帰還シフトレジスタ)を使うことです。このロジックは数個のフリップフロップと XOR ゲートで構成されるため、LFSR の実装にそれほど多くのリソースは必要ありません。よく使われる LFSR の例は、LFSR に関連する数学的トピックを扱う別のページにあります。
MGT の PCS 部分には、通常、PRBS に関連する機能がいくつかあります。特に、スクランブラ(scrambler)の実装を備えている MGT もあります。スクランブラの同期が Rx PCS に実装されていれば、多くの作業を省けます。
PRBS のもう 1 つの非常に一般的な用途は、物理チャネルのエラーテストです。受信側は LFSR を使えば正しいビット列を簡単に生成できるため、この方法は有用です。物理チャネル上のエラーは、ローカルに生成したビット列と、到着するデータストリームを比較することで検出されます。このメカニズムはロジックファブリックに実装するのは難しくありませんが、それでもこの機能を内蔵している MGT もあります。
残念ながら、PRBS を使ってエラーテストを行っている間は、物理チャネルをデータ送信に使うことはできません。したがって、チャネルが実際に使われている最中の品質を監視することは不可能です。エラーを報告するメカニズムを持つプロトコルもありますが、通常、エラーが報告されるのは、それが伝送データを乱した場合だけです。例外の 1 つが Xillyp2p で、リンクがアイドル状態のときに発生するエラーも報告します。
以上で、MGT に関するこの一連のページの 4 ページ目を終わります。次のページでは、PMA と、厳しい物理チャネルを補償する PMA の能力、およびアイスキャン(eye scanning)を行う能力について見ていきます。