概要
Xillybus の最も一般的な使用シナリオはデータ収集 (data acquisition) です。このページでは、FPGA からホストへデータを送信するための始め方を示します。
FPGA 内部での Xillybus とのやり取りについて、より詳しく知りたい場合は、Xillybus FPGA デザイナー向けガイドを参照してください。
データレートが高いアプリケーションの場合は、Linux 向けスタートアップガイドまたはMicrosoft Windows 向けスタートアップガイドの第 5 章に書かれているガイドラインを読むこともお勧めします。
ホスト側の話
Xillybus の仕組みを理解するには、コンピュータ側から見るのが最も簡単です。次のコマンドを使うと、データ収集した結果をディスクのファイルに保存できます。
$ cat /dev/xillybus_read_32 > capture-file.dat
「cat」は標準的な Linux コマンドで、ファイルからすべてのデータを読み取り、そのデータを標準出力に書き出します。この例では、入力は通常のファイルではなくデバイスファイルです。この入力は、FPGA から届くデータストリームで構成されています。標準出力はリダイレクトされているため、このデータはディスク上のファイルに書き込まれます。
これはわざとらしい例ではありません。実際の利用シナリオによっては、これが Xillybus をデータ収集に実用する正しい方法となることもあります。特定の量のデータを得るには「dd」を使うほうがよいかもしれません。より一般的には、専用のコンピュータプログラムを使ってデバイスファイルからデータを読み取ります。各アプリケーションには、それぞれ好みのデータ消費方法があります。
つまり、どのプログラミング言語を好むか、Linux と Windows のどちらを使うかは、重要ではありません。FPGA からデータを受け取るコンピュータソフトウェアは、「cat」と同じこと、つまりファイルを開いて読み出すことだけを行えばよいのです。標準的なファイル I/O のプログラミング技法については、別のページで紹介しています。Xillybus を使ったプログラミング技法のさらに詳しい情報は、Linux 向けプログラミングガイドとWindows 向けプログラミングガイドにあります。
データ収集のためのロジック
次に、FPGA の中で何が起こっているかを見てみましょう。Xillybus の IP コアとアプリケーションロジックは、FIFO を介してやり取りします。アプリケーションロジックが FIFO にデータを書き込むと、Xillybus がそのデータをホストまで届けます。FIFO の仕組みに馴染みがない場合は、別のページで FIFO の動作を説明しています。
Xillybus のデモバンドルには、xillydemo.v というファイルが含まれています。これは IP コアと接続するための Verilog コードです。デモバンドルには VHDL ファイル(xillydemo.vhd)もあります。ただし、以下の例は Verilog です。
Xillybus の IP コアのインスタンシエーション (instantiation) は、xillydemo.v(または xillydemo.vhd)の中で行われます。以下は、上記の「cat」コマンドを使ったデータ収集の例に関係する部分です(他の部分は省略しています)。
   // Wires related to /dev/xillybus_read_32
   wire        user_r_read_32_rden;
   wire        user_r_read_32_empty;
   wire [31:0] user_r_read_32_data;
   wire        user_r_read_32_eof;
   wire        user_r_read_32_open;

[ ... ]

   xillybus xillybus_ins (
[ ... ]
			  // Ports related to /dev/xillybus_read_32
			  // FPGA to CPU signals:
			  .user_r_read_32_rden(user_r_read_32_rden),
			  .user_r_read_32_empty(user_r_read_32_empty),
			  .user_r_read_32_data(user_r_read_32_data),
			  .user_r_read_32_eof(user_r_read_32_eof),
			  .user_r_read_32_open(user_r_read_32_open),
[ ... ]
			  .bus_clk(bus_clk),
[ ... ]
			  );
IP コアの各ポートの意味は、Xillybus のロジック API ガイドで詳しく説明されています。
xillydemo.v の中には FIFO のインスタンシエーションがあります。この FIFO はシングルクロック FIFO で、元の Verilog コードが示しているループバックに適しています。データ収集アプリケーションでは、データ収集ロジックが通常は独自のクロックに依存するため、デュアルクロック FIFO のほうが適しています。
そこで、xillydemo.v を次のようなデータ収集を行うモジュールに変更できます。シングルクロック FIFO(fifo_32x512 という名前です)のインスタンシエーションを削除し、代わりにこれを挿入します。
   assign user_r_read_32_eof = 0;

   dualclock_fifo_32 fifo_32
     (
      .rd_clk(bus_clk),

      .rst(!user_r_read_32_open),
      .rd_en(user_r_read_32_rden),
      .dout(user_r_read_32_data),
      .empty(user_r_read_32_empty),

      .wr_clk(capture_clk),

      .wr_en(capture_en),
      .din(capture_data),
      .full(capture_full)
      );
デュアルクロック FIFO
dualclock_fifo_32 は標準的なデュアルクロック FIFO です。これは FPGA 用の開発ソフトウェアで IP として作成する必要があります。この FIFO の深さは、512 エレメント以上にしてください。FPGA ソフトウェアの違いにより、ポート名が上記と異なる場合があります。ただし、FIFO のポートをどのように接続するかは容易に判断できるはずです。
繰り返しになりますが、FIFO に馴染みがない場合は、FIFO を紹介するページがあります。
FIFO のポートのうちいくつかは、Xillybus の IP コアに直接接続されています:@rd_clk、@rd_en、@dout、@empty です。これらの接続は、デモバンドルとまったく同じように行うことに注意してください。IP コアは、これら 4 つの信号を使って FIFO からデータを引き出します。これらのポートを IP コアに接続するときは、これが常に正しい方法です。
@rd_clk が @bus_clk に接続されていることに注意してください。この信号は Xillybus の IP コアから来ています。つまり、FIFO の一方の側で使われるクロックは、IP コアが決めているのです。
@rst については、!user_r_read_32_open に接続されていることに注意してください。@user_r_read_32_open は、ホスト上で対応するデバイスファイルが開かれている間だけハイになります。その結果、デバイスファイルが開かれていない間は FIFO がリセットされます。したがって、ホストがデバイスファイルを開いたとき、FIFO は空 (empty) です。前回のセッションで FIFO の記憶領域にデータが残っていたとしても、デバイスファイルが閉じられたときに削除されているからです。
この動作は、データのソースに通常期待されるものです。ただし、デバイスファイルが閉じられても FIFO のデータを保持したい場合は、@rst に別のものを接続するか、@rst をローに固定しても構いません。
この例では、デモバンドルと同様に @user_r_read_32_eof はゼロになっています。この信号は、ホストに end-of-file を送るために使えます。詳細はAPI ガイドを参照してください。
アプリケーションロジックとのインターフェース
データ収集アプリケーションには、常に、ホストへ送信するデータを生成する何らかのアプリケーションロジックがあります。この部分はアプリケーションごとに異なるため、ここでの議論の対象外です。ここでは、このデータをホストへ送信する部分に焦点を当てます。
この部分は驚くほど簡単です。アプリケーションロジックが FIFO にデータを書き込むだけです。FIFO に書き込まれたデータは、連続したデータストリームとしてホスト上のコンピュータプログラムに届きます。
したがって、アプリケーションロジックは、FIFO への書き込みに関する標準的な規則に従います。上の例では、@capture_clk、@capture_en、@capture_data、@capture_full で示されています。このロジックは、FIFO に正しく書き込むために、@capture_data にデータを置き、@capture_en を制御するだけでよいのです。アプリケーションロジックは、FIFO への書き込みに独自のクロックを使うことに注意してください。
データの流れ
以下は、アプリケーションロジックからホスト上のユーザーアプリケーションプログラムまでのデータの流れを表した簡略化したブロック図です。
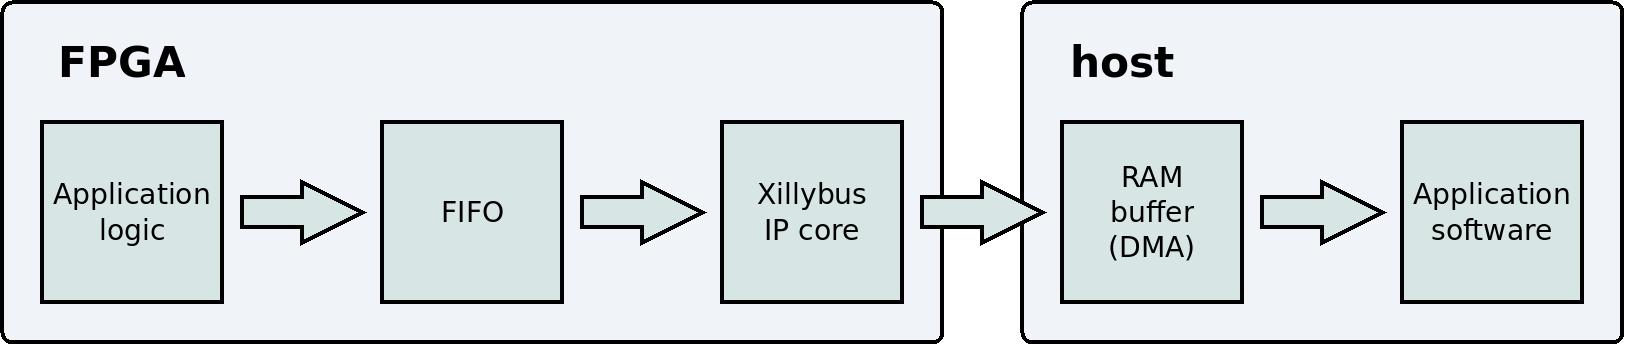
このブロック図では、2 つの技術的な詳細が省略されていることに注意してください。PCIe ブロックとカーネルドライバは、ユーザーがデータの流れをどう認識するかに関係ないため、表示されていません。Xillybus を正しく使うコツは、これらの詳細を忘れて、アプリケーションロジックとアプリケーションソフトウェアに集中することです。
データをパケットにまとめる必要はありません。アプリケーションロジックとコンピュータの間の通信チャネルは連続したストリームです。IP コアとドライバは、データの流れが他のストリームプロトコルと同じように振る舞うことを保証します。たとえば、Linux でのプログラム間のパイプなどです。同様の振る舞いを持つ別のプロトコルとして TCP/IP があります。言い換えれば、FIFO にどれだけの量のデータを書き込むかは問題ではありません。このデータは、まもなくホスト上のユーザーアプリケーションプログラムに届きます。
データをパケットに整理し、IP コアの DMA バッファをそのパケットのサイズに合わせるのは、よくある間違いです。そうすることに利点はありません。データが一定サイズのパケットで送信される場合でも、IP コアをそのサイズに適合させる必要はありません。
FIFO が full になったらどうなる?
FIFO の基本的な規則のひとつに、@full ポートがハイのときは @wr_en をローにしなければならない、というものがあります。簡単に言うと、full の FIFO に書き込んではいけません。では、もしそうなったらどうなるのでしょうか。この状況への対処は、アプリケーションロジックをかなり複雑にしてしまいます。
簡単に答えると、FIFO は full になるべきではありません。通常の動作条件では、これは積極的に防止されています。IP コアは FIFO からデータを読み出し、そのデータをホストの RAM にコピーします。これは FIFO がいっぱいになるのを防ぐのに十分な速さで行われます。通常、FIFO は 512 データ要素より深くする必要はありません。
ただし、アプリケーションロジックが FIFO に書き込む速度が速すぎると、FIFO が full になることがあります。つまり、アプリケーションロジックの平均データレートが IP コアの限界(各タイプの IP コアについて公表されています)を超えると、IP コアが FIFO から十分な速さでデータを読み出せなくなります。
もうひとつの可能性は、ユーザーアプリケーションソフトウェア(上記の例では「cat」)がデバイスファイルからデータを十分な速さで読み出さない場合です。その結果、ホスト側の RAM バッファが full になり、これも IP コアが FIFO から読み出すのを妨げます(IP コアにはデータを書き込む場所がなくなるからです)。その結果、オーバーフロー (overflow) が発生します。これは、ユーザーアプリケーションソフトウェアが適切に書かれていない場合に起こり得ます。もうひとつの考えられる原因はオペレーティングシステムに関連するもので、これについては後述します。
ホスト側の RAM バッファのサイズは、Xillybus の IP コアによって決まります。たとえば、デモバンドルに含まれる IP コアでは、xillybus_read_32 と xillybus_write_32 のバッファサイズは 4 MB です。IP Core Factory では、これよりはるかに大きなバッファを要求するカスタム IP コアを作成できます。
結論として、オーバーフローを防ぐことは、IP コアのパラメータを正しく選ぶことの問題です。まず第一に、この IP コアがデータレートを処理できる必要があります。それに加えて、ホストの RAM バッファが十分に大きい必要があります。これにより、ユーザーアプリケーションプログラムがデバイスファイルからデータを読み出していない間も、データの流れを継続できます。
それでも FIFO が full になってしまう場合、その原因はシステム設計の誤りであることが一般的です。オーバーフローのよくある原因は、コンピュータがそのデータレートを処理できる能力を過大評価していることです。
特に、データをディスク上のファイルに書き込む場合(上記の「cat」コマンドのように)、最大データレートは思ったより遅くなることがあります。その理由は、オペレーティングシステムが大きなディスクキャッシュ(場合によっては数 GB)を持つことが多いからです。ディスクのデータレートを、ディスクキャッシュより少ない量のデータで測定すると、結果は楽観的になりすぎます。オペレーティングシステムは、実際にディスクへの書き込みが完了する前に、書き込みが終わったふりをするからです。実際には、データはキャッシュに達しただけで、ディスクへの実際の書き込みは後で行われます。この誤りは、より大量のデータを扱ったときに初めて明らかになります。
CPU の奪取
残念ながら、オーバーフローには避けられない可能性があります。オペレーティングシステム(Linux または Windows)は、任意のユーザー空間プロセスから、無制限の時間 CPU を奪うことが許されています。つまり、データを読み取るコンピュータプログラムが、ある期間突然動作を停止し、その後通常の動作を再開することがあり得ます。この時間には制限がありません。非リアルタイム OS はどれも、このようにプロセスをランダムに一時停止することが許されています。
それでも、これらのオペレーティングシステムでデータ収集は可能です。これは主に、CPU の長時間の奪取は一般に好ましくない特性と見なされるためです。したがって、これらの一時停止は通常は短いものです。
これらの一時停止の間、IP コアはホストの RAM バッファへの書き込みを続けます(DMA によるので、プロセッサの介入は不要です)。コンピュータプログラムが CPU を取り戻すと、蓄積されたすべてのデータをすぐに消費できます。10 ms の一時停止を補償できる RAM バッファで通常は十分です。ただし、IP Core Factory でカスタム IP コアを作成する際に、大幅に大きなバッファを要求することも可能です。
とはいえ、一時停止が長すぎる可能性は依然としてあります。その結果、RAM バッファが full になり、その結果、FPGA 上の FIFO が full になります。このオーバーフローにより、データが失われます。これは決して起こるべきではありませんし、おそらく起こらないでしょう。しかし、もし起こったらどうなるのでしょうか。
オーバーフローの検出
推奨される解決策は、FIFO が full になったらデータストリームを終了させることです。ロジックは、連続したデータの最後の要素の直後に、ホストへ EOF(end-of-file)を送信します。では、ホストが上記のように「cat」コマンドでデータを消費する場合に何が起こるかを考えてみましょう。
$ cat /dev/xillybus_read_32 > capture-file.dat
通常、このコマンドは CTRL-C で停止されるまで続きます。しかし、FPGA 内の FIFO が full になると、このコマンドは通常のファイルのコピーが終了したときと同じように、正常に終了します。出力ファイルには、FIFO が full になる前に収集されたすべてのデータが含まれます。
この方法をまとめると、capture-file.dat に書き込まれたすべてのデータは、エラーがなく連続していることが保証されます。CPU の奪取によってデータ収集システムが連続性を維持できなかった場合、結果はより短い出力ファイルになります。しかし、ファイルの内容は信頼できます。
この解決策を実装するには、dualclock_fifo_32 のインスタンシエーションを次で置き換えます。
   eof_fifo fifo_32
     (
      .rd_clk(bus_clk),

      .rst(!user_r_read_32_open),
      .rd_en(user_r_read_32_rden),
      .dout(user_r_read_32_data),
      .empty(user_r_read_32_empty),

      .wr_clk(capture_clk),

      .wr_en(capture_en),
      .din(capture_data),
      .full(),
      .eof(user_r_read_32_eof)
      );
eof_fifo の定義は別のページにあります。
@user_r_read_32_eof がこの FIFO の @eof ポートに接続されていることに注意してください。これが、必要に応じてロジックが EOF をホストへ送る仕組みです。また、この FIFO の @full ポートには何も接続されていないことにも注意してください。この信号を監視する必要はもうありません。FIFO が full になっても、それに対してできることはあまりありません。EOF メカニズムにより、有効なデータがすべて消費された後で、ホストがデータの流れを再開することが保証されます。
データの再生
逆方向はどうでしょうか。次のようなものはどうでしょう。
$ cat playback-data.dat > /dev/xillybus_write_32
これも同じ原理で動作します。「cat」コマンドがディスク上のファイルから読み取り、そのデータをデバイスファイルに書き込みます。FPGA では、IP コアがこのデータを FIFO に書き込みます。アプリケーションロジックは、FIFO からデータを読み取ります。同じ考え方で、向きが逆になっただけです。
これは、ホスト上のユーザーアプリケーションプログラムからアプリケーションロジックへのデータの流れを表した簡略化したブロック図です。
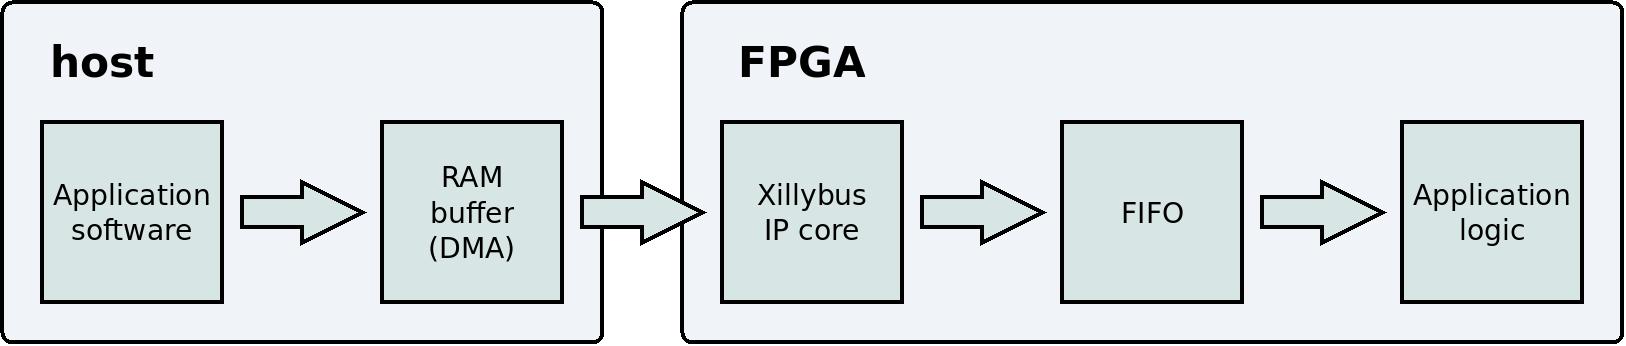
データ収集と同様に、データが失われるリスクはありません。IP コアは FIFO が full のときには書き込みを行いません。その結果、ホストの RAM のバッファも full になる可能性があります。こうなると、ホスト上のユーザーアプリケーションプログラムは、アプリケーションロジックが FIFO から十分なデータを読み取るまで待機(スリープ)します。
データ収集とのもうひとつの類似点として、ユーザーアプリケーションプログラムが十分な速さでデータを書き込み続ける限り、FIFO は空 (empty) になることはありません。これを保証するには、データ収集の場合と同じ考慮事項が当てはまります。IP コアの仕様も、ユーザーアプリケーションプログラムも、要求されるデータレートをサポートしている必要があります。
これらの条件が満たされていれば、アプリケーションロジックは、データが必要になったときに FIFO からデータを消費できます。アンダーフロー (underflow) は決して発生しないはずです。
非同期ストリームと同期ストリーム
このトピックは直接関係ありませんが、簡単に説明する価値はあります。
データ収集アプリケーションでは、主な目標は連続したデータの流れを維持することです。したがって、IP コアは、できるだけ早くデータを FIFO からホストの RAM バッファへ移動します。ホスト上のユーザーアプリケーションプログラムがその瞬間にデータを要求しているかどうか(read() などの関数呼び出しによって)は関係ありません。デバイスファイルが開かれていて FIFO にデータがある限り、データの流れは続きます。
つまり、ホスト側には FPGA からのデータの流れを制御する方法がありません(デバイスファイルを開いたり閉じたりするか、アプリケーション固有の解決策に頼る場合を除く)。しかし、ほとんどの実際のデータ収集アプリケーションでは、データの流れを制御する必要はありません。デバイスファイルを開くことによってデータの流れが始まるので問題ありません。各データ要素が FIFO から読み取られた正確な時刻は重要ではありません。
このように動作するデバイスファイルは、(Xillybus の用語で)非同期ストリーム (asynchronous stream) と呼ばれます。
しかし、他のアプリケーションでは、データが収集された時刻が重要です。たとえば、FPGA 上のアプリケーションロジックが、FIFO からのデータではなく、ステータスレジスタの内容を送る場合があります。これは、デモバンドルで xillybus_mem_8 という名前のデバイスファイルによって実証されています。この場合、FPGA でデータが収集されるタイミングを制御することが非常に重要です。ホストは、その瞬間のステータスを知るためにデバイスファイルを読み取るのであって、過去の不明な時点のステータスを知りたいわけではありません。
Xillybus には、この種のアプリケーション向けの同期ストリーム (synchronous stream) があります。同期ストリームでは、IP コアは常に FPGA から収集するデータ量を最小限に抑えます。つまり、IP コアは、ホスト側で read()(または同様の関数)が呼び出されたときにだけデータを収集します。したがって、FPGA からデータが収集されるタイミングをホストが制御します。
同期ストリームの欠点は、データの流れに一時停止が生じることです。これらの一時停止の主な問題は、データの流れが一時的に止まると、FPGA 上の FIFO が full になり得ることです。また、これらの一時停止はデータの流れの効率を低下させるため、最大データレートが低くなります。ただし、これらの 2 つの欠点は、データ収集アプリケーションにのみ関係します。そのようなアプリケーションは、いずれにしても非同期ストリームを使うべきです。
逆方向のデバイスファイルについても、非同期ストリームと同期ストリームの間には違いがあります。この方向では、write() 関数呼び出しの戻り方が違います。非同期ストリームでは、write() はデータが RAM バッファに書き込まれるとすぐに戻ります。したがって、ほとんどの場合、write() はまったくスリープしません。一方、同期ストリームでは、write() はデータが FPGA に届くまで待機します。これは、通信チャネルをコマンド送信に使う場合に重要です。しかし、繰り返しになりますが、データ収集アプリケーションにとってはこれも不利に働きます。
デモバンドルでは、/dev/xillybus_mem_8 だけが同期ストリームです。他の 4 つのデバイスファイルはすべて非同期ストリームです。
IP Core Factory では、同期ストリームと非同期ストリームのどちらを選ぶかは、アプリケーションの選択(「use」のドロップダウンメニュー)によって決まります。たとえば、「Data acquisition / playback」を選ぶと、ツールは非同期ストリームを生成します。「Command and status」を選ぶと、同期ストリームになります。「Autoset internals」をオフにして、手動で選択することも可能です。
非同期ストリームと同期ストリームの詳細については、Linux 向けプログラミングガイド(またはWindows 向けプログラミングガイド)の第 2 節を参照してください。IP Core Factory については、カスタム Xillybus IP コア定義ガイドを参照してください。
まとめ
Xillybus を使えば、単純でありながら実際に機能するデータ収集システムを、簡単かつ迅速に作れます。アプリケーションソフトウェアは、標準的な Linux コマンド(「cat」)を使うことに帰着します。FPGA 側では、Xillybus の IP コアとのやり取りは、FIFO にデータを書き込むだけです。
Xillybus で収集されたデータは、エラーがなく連続していることが保証されます。ただし、オペレーティングシステムの性質上、オーバーフローが決して発生しないことを保証する方法はありません。これは避けられないことなので、最善の方法は、オーバーフローが発生した場合にそれを確実に検出できるようにすることです。Xillybus は、EOF をホストに送信するという簡単なメカニズムをこの目的のために提供しています。