このページは、クロックドメインに関する全3回のシリーズの第2回です。
対象範囲
前のページで述べたように、パスが関連クロック同士のクロックドメイン間をまたぐ場合、ロジック側で特別な処理は不要です。それでも、終点にある同期要素のタイミング要件(セットアップとホールド)を保証するために、FPGA ツールがこのパスにタイミング制約(timing constraints)を適用することを確認する必要があります。つまり、このケースはタイミング解析の対象になるという意味で、クロックドメインクロッシング(clock domain crossing)がまったくないかのように扱われます。
一方、クロックが無関係クロック(unrelated clocks)の場合には、再同期ロジックが必要です。この問題を解決するための専用のコードを Verilog(または別の言語)で書かなければなりません。このページでは、その基本的なやり方を説明します。
できるなら FIFO を使いましょう
まず最初に、この頭痛の種を完全に避ける方法を紹介するのがフェアだと思います。逃げ道がある人のために。それは次のとおりです。
FPGA ツールが生成するデュアルクロック FIFO は、クロックドメインをまたぐ方法として間違いなく最も安全です。これは最も一般的な解決策であり、これほど広く使われているという事実自体が、信頼するに足る理由になっています。
特に FPGA に慣れていないなら、たとえそのために自分の設計を少し変更する必要があっても、FIFO を使うのがよい理由があります。FIFO を使うと、目的に合わせて作ったロジックより若干多くのリソースを消費するかもしれません。ただし、FIFO の深さが浅い場合は、通常はブロック RAM が必要ないことに注意してください。つまり、この差は、設計を台無しにするリスクに見合うものとは限りません。
FIFO は、特に一方の機能ユニットからもう一方へデータストリームが流れる場合、クロックドメインをまたぐための自然な解決策になることがよくあります。しかし、それほど自然でない場合でも、ロジックを組み替えて適合させられることがよくあります。たとえば、あるクロックドメインのロジックが別のクロックドメインのロジックに何らかのイベントを通知する必要があるとしましょう。これは、メッセージの語を符号化して浅い FIFO に書き込むことで実現できます。この種の方法はバグが起きにくいだけでなく、設計がより整理されて読みやすくなる可能性も高いです。
FIFO の接続方法と使い方は、FIFO に関する一連のページで詳しく説明しています。
1 ビットだけの再同期ロジック
FIFO では解決できない場合は、袖をまくって安全なクロックドメインクロッシングのための再同期ロジックを実装するときです。このページの残りでは、幅が 1 ビットの信号をクロックドメイン間で渡す話に限定します。これはあらゆる再同期ロジックの基礎であり、この一見単純なケースにも語るべきことはたくさんあります。
このシリーズの次のページでは、以下で紹介するメタステイビリティガードの技術に基づいて、より幅の広い信号をクロックドメイン間で渡す方法を解説します。
メタステイビリティ
解決策に進む前に、フリップフロップのタイミング要件が満たされないと何が起きるのかを理解することが重要です。つまり、データ入力の信号が、クロックエッジの tsu 前から thold 後までの期間に安定していない場合です。問題となるクロックエッジは、もちろんフリップフロップのクロック入力に加わるエッジです。このエッジによってデータ入力がサンプリングされるのです。
この期間中にデータが変化すれば、このクロックエッジ後のフリップフロップ出力は予測不能になります。しかし、それはまだ序の口で、もっと悪いことがあります。フリップフロップが '0' または '1' という正しい値を出力するまでに、通常より大幅に長い時間がかかることがあります。フリップフロップは、これら2つの値のいずれかに出力を安定させるように設計されていますが、タイミング要件の違反により、短時間だけ不安定な状態にとどまることがあります。専門用語では、フリップフロップがメタステイビリティ(metastability)状態になると言います。
ここで定番のイメージを省略しないことにします。丘の頂点で立っているボールの図は、フリップフロップが陥り得る不安定な状況を表すためによく使われます。
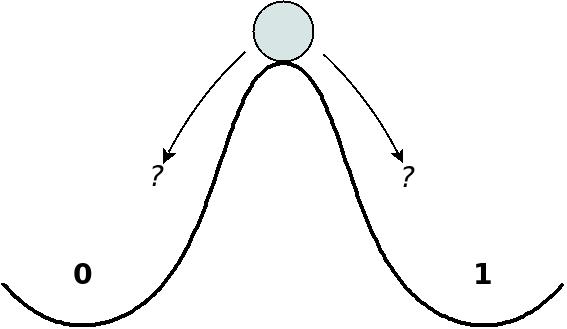
メタステイビリティは、フリップフロップが最終的にどちらに落ち着くかが不明だという問題より、はるかに大きい問題です。特に、そのフリップフロップの出力が複数の接続先に接続されている場合に顕著になります。'0' か '1' かに落ち着くまでに時間がかかるため、出力が安定するのが接続先のフリップフロップに対して遅すぎることがあります。その結果、接続先のフリップフロップの一部はふらつく信号を '0' として受け取り、別のフリップフロップは '1' として受け取るかもしれません。この不一致によってロジックが不正な状態に陥り、そこからブラックマジックのような動作をすることがあります。したがって、メタステイビリティのリスクがあるフリップフロップは、決して複数のロジック要素に接続してはいけません。
メタステイビリティに対処するには、フリップフロップが安定状態のどちらかに落ち着くまでにどれだけの時間がかかるかを知りたいところです。残念ながら、それには明確な答えがありません。丘の頂上でボールがどれだけ長く静止しているかと聞くのと同じです。多くの要因に依存し、結局はランダムな振動によってどちらかに転がり落ちるのがオチです。フリップフロップのメタステイビリティも同じです。電子回路内のランダムなノイズなどによって、この状態から脱出することになります。
理論上は、フリップフロップが永遠にメタステイビリティ状態にとどまることもあり得ます。しかし現実には、しばらくするとどちらかの安定状態に落ち着きます。この状態に留まる時間はランダム変数です。このランダム変数の挙動を推定しようと、多くの実験やシミュレーションが行われてきました。しかし、これらの試みはどれも実際にはあまり意味がありません。その挙動は、シリコンの製造プロセス、温度、クロストークによるノイズレベルなどに依存するからです。
繰り返しになりますが、フリップフロップがメタステイビリティ状態で決して超えない最大時間が規定されていれば便利なのですが、そのような制限はありません。おおよその値さえ得ることはできません。新しい製造プロセスで作られたフリップフロップは、メタステイビリティ状態からより早く抜け出す傾向があるからです。
その代わりに、次の考え方に慣れる必要があります。無関係クロック同士でクロックドメインをまたぐときは、あるフリップフロップが設計で許容できる時間より長くメタステイビリティ状態にとどまり、その結果何かがうまくいかない可能性が常にあります。設計者としてできるのは、このリスクを減らすことだけです。せいぜい、受け入れられる MTBF(平均故障間隔、Mean Time Between Failure)を達成するのが関の山です。
幸いなことに、まさにそれを実現する確立された技術があります。次の話題に進みましょう。
メタステイビリティガード
話を手短にしましょう。前のページの最初のコード例をもう一度見てみます。@clk1 と @clk2 が無関係クロックの場合、@foo から安定した @bar を得るための一般的な再同期ロジックは次のとおりです。
reg foo, bar, bar_metaguard;

always @(posedge clk1)
  foo <= !foo;

always @(posedge clk2)
  begin
    bar_metaguard <= foo;
    bar <= bar_metaguard;
  end
その名前が示すとおり、@bar_metaguard はメタステイビリティガード(metastability guard)です。@foo をサンプリングするとき、@bar_metaguard を実装するフリップフロップのタイミング要件は時々違反されます。したがって、@bar_metaguard は短いメタステイビリティ状態を起こし得ます。このフリップフロップはすぐに回復することが期待できるので、@bar のセットアップ時間の要件を満たすのに十分な速さで安定します。その結果、@bar は @clk2 のクロックドメイン内で安全に使えます。
この説明はいい加減に聞こえるかもしれません。実際、そのとおりいい加減です。上でメタステイビリティについて書いたことと矛盾しています。メタステイビリティに絶対安全な解決策はないからです。この点については後でもう一度取り上げます。しかし、ひとまずは上に示したようなメタステイビリティガードを追加して、それ以上心配しないという一般的な慣行に従いましょう。正直に言うと、これで問題が起きたという話は聞いたことがありません。
さらに安全を期したい人は、レジスタを追加します。2 段のメタステイビリティガードは、たとえば次のようにします。
reg foo, bar, bar_metaguard_a, bar_metaguard_b;

always @(posedge clk1)
  foo <= !foo;

always @(posedge clk2)
  begin
    bar_metaguard_a <= foo;
    bar_metaguard_b <= bar_metaguard_a;
    bar <= bar_metaguard_b;
  end
@bar_metaguard_a が最初のメタステイビリティガードです。運が悪いと @bar_metaguard_a がメタステイビリティ状態に長くとどまり、@bar_metaguard_b のタイミング要件が違反されます。その結果、@bar_metaguard_b は次のクロックサイクルでメタステイビリティ状態になります。しかし今度は、その状態が短いと期待できます。雷は同じ場所に二度落ちないと言いますから。もちろん、@bar_metaguard_b も @bar のタイミング要件を違反するほど長くメタステイビリティ状態にとどまる可能性はあります。しかし、その確率はどれほどでしょう?目標は妥当な MTBF を得ることだったことを思い出してください。
まとめましょう。1 ビットの信号をクロックドメイン間で渡すための定石的な解決策を探しているなら、これがそれです。メタステイビリティガードを 1 段または 2 段入れれば、うまく機能します。決して失敗しない解決策を探しているなら、残念ながらそれは不可能です。しかし、事故の確率をできる限り減らしたいなら、読み進めてください。
メタステイビリティのタイミング解析
では、単段のメタステイビリティガードの例に戻って、なぜ @bar_metaguard が十分速く回復すると私が確信していたのかを考えましょう。答えは、すでに述べたとおり、確信できる理由はないということです。
それでも、少しタイミング解析をしてみましょう。@bar_metaguard と @bar はどちらも同じクロック @clk2 に同期しています。これらのレジスタに特別なタイミング制約が割り当てられていないと仮定すると、その間のパスは @clk2 のタイミング制約(クロック周期)によって制約されます。言い換えれば、ツールはメタステイビリティがない場合に、@bar の入力信号が正しいタイミングでサンプリングされることを保証します。
しかし、@bar_metaguard のそもそもの意義は、時折メタステイビリティを許容することにあります。したがって、このタイミング解析だけでは不十分です。実際には、フリップフロップがメタステイビリティ状態で過ごす時間は、クロックから出力までの遅延(clock-to-output delay)に追加されます。言い換えれば、メタステイビリティが起きると、フリップフロップの出力は通常の遅延より遅く安定するのです。したがって、@bar_metaguard から @bar へのパスのスラック(slack)がほぼゼロ(つまり伝搬遅延がタイミングを達成するにはギリギリで、余裕がない)の場合、メタステイビリティによってパスの合計遅延が許容値を超える可能性があります。そのような事態が起きれば、@bar の入力でタイミング違反になります。もちろんこれは温度・電圧・製造プロセスの最悪条件での話ですが、それでもなお、ツールがメタステイビリティガードの出力に通常のタイミング制約を適用するという事実は、必要なタイミング要件を保証していないことを意味します。
幸い、これは簡単に直せます。いや、「改善」と言うべきでしょう。方法は、メタステイビリティガードから、確実に動作させる必要があるレジスタに至るすべてのパスに対して、より厳しいタイミング制約を追加することです。つまり、これらのパスの伝搬遅延(propagation delay)に許される時間を短くするのです。伝搬遅延に許される時間を減らすことで、浮いた時間をメタステイビリティからの回復に充てるという考え方です。
たとえば、すべてのメタステイビリティガード用レジスタに *_metaguard という接尾辞が付いていれば、それらから始まるすべてのパスに、安定化のための追加時間を要求するタイミング制約を 1 行で書けます。Vivado の場合、次のような制約になります。
set_max_delay -from [ get_cells -hier -filter {name=~*_metaguard*} ] 0.75
(set_max_delay については、タイミング例外のページで説明しています)
このタイミング制約は、メタステイビリティガードから始まるすべてのパスが、到達先まで 0.75 ns 以内で届かなければならないことを意味します(これらのパスは、レジスタ名の接尾辞で選択されます)。この 0.75 ns という値は、私が試した特定の FPGA でタイミング制約を失敗させずに達成できた最小の値です(なので、他の FPGA では異なるかもしれません)。この数値の出し方は、ツールが制約を達成できなくなるまで値を下げていき、失敗したら、スラックがごく小さくなる(たとえば 0.2 ns)ように値を必要なだけ上げるというものです。これにより、ツールはこれらのパスに対して全力を尽くすことになります。
この set_max_delay 制約は、0.75 ns(1333 MHz)のクロック周期を要求するのと同じです。たとえば、実際のクロック周期が 250 MHz(4 ns)なら、このタイミング制約を達成することで少なくとも 4 - 0.75 = 3.25 ns の余裕が得られます。したがって、メタステイビリティガードが最大 3.25 ns までメタステイビリティ状態にとどまっても、この set_max_delay 制約のおかげでタイミング違反は発生しません。
これは、何の保証もないよりは確かにましです。しかし、3.25 ns で十分なのでしょうか?それは大きいのでしょうか?事実上フェイルセーフなクロックドメイン移行を保証するには十分なのでしょうか?
すでに述べたとおり、答えはいくつかの要因に依存します。公表されている実験結果から判断すると、今日実際に使われている FPGA で、フリップフロップが 1 ns もの長さメタステイビリティ状態にとどまることは、私個人の印象では極めて考えにくいです。とはいえ、この問題について確かなことを言うのは困難ですが。
しかし、このタイミング制約を追加してツールに全力を尽くさせることで、あなたの FPGA 設計は他の誰の状況とも同等か、それ以上になります。ですから、黄金則 #4(運を試すな)の精神に従い、もし失敗したら他の大勢の人たちも文句を言う理由がある、という立場に身を置いてください。
もう 1 つの洞察は、使用している FPGA にとってクロック周波数が高い場合、2 段のメタステイビリティガードが良い考えかもしれないということです。これは特に、前述の追加タイミング制約を使っていない場合に当てはまります。前述のとおり、メタステイビリティはスラックを消費します。クロック周期が小さくなる(周波数が高くなる)につれて、スラックはしばしば少なくなり、したがってメタステイビリティのための追加時間も少なくなります。
最後に、どうしてほとんど誰もこのタイミングの問題を無視しているのに、誰も問題を訴えないのか、という疑問に答えましょう。いくつか考えられる説明を述べますが、これらはあくまで推測です。
1 つ目の説明は、FPGA のロジックファブリック上で、ツールがメタステイビリティガードをもう一方のフリップフロップの物理的にごく近くに配置する可能性が高いということです。したがって、これら 2 つのフリップフロップ間(たとえば @bar_metaguard から @bar)の伝搬遅延は、その FPGA にとってはともかく非常に短くなります。しかし、このような密な配置は、前述のとおり明示的なタイミング制約なしには保証されません。
FPGA ベンダーが提供する公式 FIFO の中では、この種のフリップフロップのペアが同じスライス(slice)上にあることがよくあります。いずれにせよ、公式の FIFO はこの問題が解決済みであると信頼できます。
もう 1 つの点は、FPGA が高速化し、より高いクロック周波数が可能になるにつれ、フリップフロップもメタステイビリティからより速く抜け出すようになっているということです。したがって、メタステイビリティからの回復時間と伝搬遅延を合わせても、クロック周期よりかなり短いままです。
したがって、ほとんどの人がメタステイビリティガードを追加して、それ以上心配しないのも不思議ではありません。しかし、それは制約を追加する手間を惜しんでよい言い訳にはなりません。
クロック周波数の制約
ここまで、どちらのクロックドメインのクロック周波数についてもあまり触れてきませんでした。たとえば、送信元のクロックドメインのクロック(@clk1)が、送信先のクロック(@clk2)より速い場合はどうなるでしょうか?
クロック間の同期は必要ないので、送信元の周波数が高いか低いか自体は問題になりません。しかし、送信元の信号(@foo)の変化が速すぎると、送信先のフリップフロップがその変化をサンプリングする機会を得る前に、信号が行ったり来たり変化してしまうかもしれません。したがって、すべての遷移を送信先で捉える必要があるなら、送信元のクロック周期は送信先のクロック周期よりわずかに長く(つまり周波数が低く)なければなりません。
どれだけ長く?それほど長くはありません。どうしても正確な答えが欲しいなら、主に送信先フリップフロップのタイミング要件に依存します。以下に簡単な計算を示します(興味がなければ読み飛ばしてかまいません)。
このフリップフロップの入力が、そのクロックエッジのちょうど tsu 前に変化した場合、正しくサンプリングされるかどうかの瀬戸際にあります。したがって、これは次のクロックサイクルでサンプリングされなければなりません。そうでなければ、この変化は取り逃がされるかもしれません。この変化を次のクロックサイクルで確実にサンプリングするには、入力信号が次のクロックエッジの後 thold まで安定したままでなければなりません。したがって、送信元のクロック周期は、送信先のクロック周期より tsu + thold + 2tj だけ長くなければなりません。tj はクロック周期の不確かさ(ジッタ、jitter)です。ジッタが 2 回数えられているのは、送信元のクロックと送信先のクロックの両方に 1 回ずつあるからです。
したがって、私が「わずかに長い」クロック周期と言ったのは、tsu + thold + 2tj のことです。
メタステイビリティガードをツールに知らせる
一部の FPGA ツールのドキュメントでは、メタステイビリティガードとして使うフリップフロップに属性を追加することを推奨しています。これにより、ツールがこれらのフリップフロップを操作するのを防ぎます。また、メタステイビリティガードを次のフリップフロップと同じスライスに配置するようツールを促し、配線をできるだけ短くします。
たとえば、Vivado には ASYNC_REG という属性があります。先ほどと同じように、すべてのメタステイビリティガード用レジスタに *_metaguard という接尾辞が付いていれば、XDC ファイルの次の 1 行で必要な属性を設定できます。
set_property ASYNC_REG true [get_cells -hier -filter {name=~*_metaguard*}]
この属性は Verilog コード内で設定することもできます。
ただし、この属性を追加しても結果は変わらない可能性が高いです。ツールは通常、メタステイビリティガードを正しく扱うからです。