本稿は、Xilinx の Vivado における部分再構成(Partial Reconfiguration)、別名 Dynamic Function eXchange(DFX)についての全 4 回の連載の最初の投稿です。ここではこのテーマの主要な概念を説明し、部分再構成を使用する FPGA プロジェクトをセットアップする実践手順を扱う次回の土台を固めます。
はじめに
部分再構成(Partial Reconfiguration)は、FPGA の一部のロジックを、他の部分が通常どおり動作している最中に置き換えることを可能にする技法です。電源投入時に機能をプログラムする初期ビットストリーム(bitstream)とまったく同様に、ビットストリームを FPGA に供給します。ただし部分再構成用ビットストリームは FPGA を停止させません。その代わり、特定のロジック要素に働きかけ、それらの動作を制御するメモリセルを更新します。特定のロジックブロックを稼働中に差し替える、ホットリプレースです。
Xilinx の FPGA は Virtex-4 以降この機能をサポートしています(Intel の FPGA では Series-V 以降)。
この記事では、部分再構成の背後にある概念を、実際の技術的詳細には立ち入らずに説明します。実践的な詳細は次回で扱います。このテーマは何もかもが互いに関連し合っているため、個々の操作に分解する前に、全体像を理解することが重要です。
もう一度説明すると?
まず、部分再構成を使わずに FPGA の機能を変更する方法を考えてみましょう。デザイン階層のどこかにモジュールのインスタンシエーション(instantiation)があるとします。たとえば Verilog では次のようになります。
   moduleA reconfig_ins
     (
      .clk(clk),
      .this(this_w),
      .that(that_w),
 [ ... ]
      );
または VHDL では次のようになります。
  reconfig_ins : moduleA
    port map(
      clk        => clk,
      this       => this_w,
      that       => that_w,
 [ ... ]
      );
当然、プロジェクトのどこかに moduleA.v または moduleA.vhd という名前のモジュール、または moduleA という IP コア(IP core)があり、(そのサブモジュールも含めて)インスタンシエーションの中身を構成しています。そこでプロジェクトの実装を行い、ビットストリームファイルを取得して FPGA にロードします。ここまでは通常の手順です。
では、上記コードの moduleA の代わりに moduleB を書き、そのロジックを実装してビットストリームファイルを得たとしましょう。これを機能させるには、デザインの中に moduleB.v または moduleB.vhd、あるいは moduleB という IP が存在しなければなりません。
これで、reconfig_ins というインスタンス内部のロジックが異なる 2 つのビットストリームファイルができました。これらのビットストリームを切り替えるには、所望のビットストリームを FPGA 全体にロードし直す必要があります。つまり FPGA の動作が中断されます。
部分再構成は、この中断なしに一方のバージョンからもう一方へ切り替えられるようにする技法です。reconfig_ins 内のロジックが moduleA から moduleB へ、またはその逆に変化している間も、FPGA は通常どおり動作し続けます。言うまでもなく、これは 2 つのデザインを別々に実装するだけでは実現できません。
moduleA と moduleB はリコンフィギャラブルモジュール(Reconfigurable Module、RM)と呼ばれます。これは、それらのロジックを部分再構成によって FPGA に書き込むことができることを意味します。
動機
部分再構成を使う理由はいくつかあります。たとえば次のとおりです。
- フラッシュメモリへの書き込みなしで FPGA のロジックをリモートアップデート(Remote Update)できるようにする。たとえば FPGA が PCIe 経由でコンピュータに接続されている場合、ホスト側ソフトウェアのアップグレードに合わせて FPGA ロジックもアップグレードしたいことがよくあります。両者のバージョンを確実に一致させるには、FPGA のビットストリームをコンピュータ上に置き、PCIe インターフェイスを使って FPGA にロードするのが自然です(これを簡単に実現する方法についてはこちらのページを参照)。
- 大規模 FPGA の場合、すべてのロジックを含むビットストリームをロードする時間は長すぎることがあります。これは圧縮ビットストリームを使い、初期ビットストリームには必要最小限のロジックだけを実装することで解決できます。そうすれば FPGA はごく初期のうちに動作を開始し、どうしても必要な処理を実行できます。残りのロジックは第二段階として部分再構成でロードします。これは「タンデム構成(Tandem Configuration)」とも呼ばれます。
- 同時に動作させる必要のないさまざまなタスクでロジックリソースを再利用し、FPGA のコストを下げる。たとえば FPGA が複数の画像フィルタのうち 1 つを実装する場合、現在使用中の画像フィルタだけが FPGA ロジックを占有します。別のフィルタが必要になったら、そのフィルタ用に割り当てられた FPGA 内領域だけをリロードし、FPGA の残りの部分は通常どおり動作し続けます。
- JTAG 経由で特定のロジック要素を更新する。たとえば、FPGA 上で動作するマイクロプロセッサの実行コードを格納しているブロック RAM が対象です。これによりソフトウェアの開発サイクルを短縮できます。
- FPGA 上で動作中のデザインにデータプローブやデバッグツールを差し込む。特に、FPGA デザインの実装を変えると現れたり消えたりするような問題(クロックやタイミング等に関する根本的なデザイン欠陥を示唆していますが、それは別の話です)に部分再構成は有用です。
部分ビットストリーム
FPGA デザインの経験があれば、次のような単純な作業に慣れ親しんでいるのではないでしょうか。デザインのソースコード(および IP)を少し編集し、実装ツールを起動して、問題なく完了することを確認します。それから JTAG 経由でビットストリームを FPGA にロードする。あるいはビットストリームのイメージをフラッシュデバイスに書き込む。そうした流れです。
皆がその作業に慣れているがゆえに、ビットストリームは「FPGA 全体を満たす、各ロジック要素の動作を決める不思議な情報の塊」と誤解されがちです。実際には、ビットストリームは FPGA にロードされる際に順番に実行される一連のコマンドで構成されています。通常のビットストリームも FPGA 全体へ情報をロードしますが、それは処理の進行を制御する複数のコマンドによって行われます。さらに重要なのは、これらのコマンドが、各データをどのロジック要素にロードするかを決めていることです。
ビットストリーム自身が影響を与えるロジック要素を指定するので、一部のロジック要素だけを変更し、他のロジック要素はそのままにするビットストリームを作ることが可能です。これが部分再構成の要(かなめ)です。
とはいえ、部分ビットストリームは、FPGA にすでにロードされているロジックと互換性がなければなりません。単に誤ったロジック要素を上書きするという問題ではありません。初期ビットストリームは、部分ビットストリームによって変更される領域の内部にあるロジック資源や配線資源も使用しているため、両者は密接に結び付いています。部分ビットストリームが初期ビットストリームに対して正しく作られていれば、このデリケートな連携は誰の目にも触れません。そうでなければ、変更されるはずのなかった機能まで含めて、FPGA はおそらく誤動作するでしょう。
部分ビットストリームのロード
部分構成(Partial Configuration)のビットストリームを FPGA に供給するには、ビットストリームをロードできるインターフェイスであれば、FPGA が動作中でも可能な限りどれを使ってでも行えます。JTAG インターフェイスも含まれるので、部分構成用の .bit ファイルは通常どおり Hardware Manager からロードできます。さらに興味深いのは、FPGA 自身のロジックの内部から、専用の内部構成アクセスポート(Internal Configuration Access Port、ICAP)を使ってロードできることです。このポートは部分再構成にのみ使えます。ビットストリームをロードする FPGA ロジックファブリック内の部分は、処理中ずっと無傷でなければならないためです。
ICAP は FPGA のビットストリームロード用サブシステムへの単なるインターフェイスであり、ビットストリームの供給元については何も制約しません。したがって、ビットストリームデータが FPGA にどのように届くか、どこにどのように保存されるかについても制限はありません。ICAP にデータを送る FPGA ロジックから利用できる状態になっていればよいだけです。
たとえば Xillybus は、ボードに PCIe または USB 3.x インターフェイスがあれば、コンピュータから ICAP へビットストリームファイルを送るための簡単な手段を提供しています。
スタティックロジック
部分再構成を正しく行うには、その反対側に当たるスタティックロジック(static logic)を尊重しなければなりません。これは FPGA デザインの中で手を加えずに残す必要がある部分を指す総称で、初期ビットストリームがロードされたときから存在しています。
このロジックが「静的」であることには、2 つの側面があります。1 つは機能的な側面で、スタティックロジックは FPGA デザイン(HDL と IP)の中で、FPGA の初期起動から絶え間なく機能する部分からなるということです。もう 1 つは、それと同様に重要な側面ですが、このロジックの配置が、ロジックファブリック内でスタティック用に割り当てられたサイトだけに制限されるということです。これらのサイトに対する後からの操作は一切許可されません。
実用的なデザインでは、スタティックロジックが変更されないだけで十分ではなく、FPGA の他の部分が変更されている間も、スタティックロジックが正しく機能し続けることも重要です。スタティックロジックと変更されるロジックの間を結ぶネットがほぼ確実に存在するため、すべてがスムーズに動作するようにするのは FPGA 設計者の責任です。この点については本連載の第 3 回で説明します。
スタティックロジックとリコンフィギャラブルロジックの分離
部分再構成を可能にするには、スタティックロジックとリコンフィギャラブルロジックの間に厳密な分離がなければなりません。特に、FPGA 上の物理的なロジック要素を分離し、ビットストリームのロード時にスタティックロジックを含むサイトが一切影響を受けないようにする必要があります。
それが何を要求するのかを理解するために、まず私たちが慣れ親しんでいるやり方を見てみましょう。
通常の FPGA 実装プロセスは HDL デザインの合成(synthesis)から始まることを思い出してください。HDL におけるモジュールのインスタンシエーションは、モジュール同士の分離を意味しません。むしろ逆です。シンセサイザ(synthesizer)はインスタンシエーションを「ロジックがどう動作すべきか」の記述として扱います。したがってシンセサイザは、デザイン全体を 1 つの大きなフラットなロジックとして自由に扱えます。モジュールの境界を越える最適化は許されるだけでなく、むしろ望ましいことであり、頻繁に行われます。たとえば、モジュール X 内のあるレジスタが、モジュール Y 内のまったく無関係なレジスタと等価である場合、どちらかのレジスタは削除され、残った 1 つのレジスタが両方のモジュールで使われます(シンセサイザに対してそれを控えるよう明示的に指示しない限り)。
HDL の合成が完了すると、合成後のネットリストが、デザインの IP(あれば)のネットリストと結合されます。
次に、この大きなロジック要素の塊が FPGA のロジックファブリック全体に配置され、タイミング制約(timing constraints)やその他の目標を達成するように配線が行われます。デザインの別々の部分に属するロジックが同じスライス(slice)に詰め込まれたり、FPGA の離れた場所に配置されたりすることもあります。デザインをほんの少し変更しただけでも、配置が劇的に変わることがあります。各実装は独立しており、ロジックが FPGA のファブリック上にどう散らばろうと気にする必要はないので、これは無秩序に見えても害はありません。
部分再構成に話を戻します。先ほど述べたように、この機能を可能にするには、スタティックロジックとリコンフィギャラブルロジックの明確な区別が必要です。これを保証するために、階層設計(Hierarchical Design)と呼ばれる手法が使われます。その考え方は、デザイン全体を PCB 上の物理部品のように、コンポーネントの集まりと見なすことです。その結果、各コンポーネント(つまりインスタンス化されたモジュール)にはロジックファブリック上の一定領域が割り当てられます。また、各コンポーネントは分離する必要があるため、コンポーネント単位で合成を行うのが合理的です。ちょうど部品を個別に製造するのと同じです。
この概念を部分再構成と結び付けると、デザイン作業における主な違いは次の 2 点に集約されます。
- フロアプランニング(floorplanning): FPGA 設計者は、リコンフィギャラブルロジック用に FPGA ファブリック内の物理領域を明示的に割り当てる必要があります。この領域はリコンフィギャラブルパーティション(reconfigurable partition)と呼ばれます。残りの領域にはスタティックロジックが配置されます。
- 合成: リコンフィギャラブルロジック(場合によっては関連 IP も)の合成は、スタティックロジックとは別に行われます。その結果、リコンフィギャラブルロジック用とスタティックロジック用の独立したネットリストが得られます。
Pblocks
Vivado では、フロアプランニング単位のことをPblock と呼びます。これは Vivado 内部で情報を保持する単なる入れ物です。Pblock を作成し、それにロジックセルを追加し、さらに FPGA のロジックサイトのグループ(セット)を追加する Tcl 関数があります。Vivado はこれを配置制約として解釈し、Pblock に追加されたロジックセルは、その Pblock に割り当てられたサイトにのみ配置できるようになります。つまり結局のところ、Pblock は XDC ファイル内の他の制約と変わりません。
Pblock は多くの場合、Vivado の GUI を使って定義されます。合成後デザインまたは実装後デザインを開き、FPGA のグラフィカル表示の上に矩形領域を描画します。これにより、描いた矩形内のすべてのロジック要素を含む Pblock が作成されます。より正確には、すべての種類のロジック要素が含まれるわけではなく、(その FPGA ファミリで)フロアプランニングが許可されているものだけが含まれます。そして Vivado はその矩形をロジック要素の範囲に変換します。
XDC ファイルを編集してこれらの範囲を手動で設定することも同様に可能です。また、複数の矩形からなる領域を作成することもでき、形状を 1 つの矩形より複雑にしても構いません。ただし Xilinx のマニュアル(UG909)は、配線上の困難を避けるため、形状は単純に保つことを推奨しています。
これは Kintex-7 用の XDC ファイルの例です。
create_pblock pblock_pr_block_ins
add_cells_to_pblock [get_pblocks pblock_pr_block_ins] [get_cells -quiet [list pr_block_ins]]
resize_pblock [get_pblocks pblock_pr_block_ins] -add {SLICE_X118Y0:SLICE_X153Y99 SLICE_X118Y250:SLICE_X145Y349 SLICE_X0Y0:SLICE_X117Y349}
resize_pblock [get_pblocks pblock_pr_block_ins] -add {DSP48_X5Y100:DSP48_X5Y139 DSP48_X5Y0:DSP48_X5Y39 DSP48_X0Y0:DSP48_X4Y139}
resize_pblock [get_pblocks pblock_pr_block_ins] -add {RAMB18_X4Y0:RAMB18_X6Y39 RAMB18_X4Y100:RAMB18_X5Y139 RAMB18_X0Y0:RAMB18_X3Y139}
resize_pblock [get_pblocks pblock_pr_block_ins] -add {RAMB36_X4Y0:RAMB36_X6Y19 RAMB36_X4Y50:RAMB36_X5Y69 RAMB36_X0Y0:RAMB36_X3Y69}
下の画像は、実装後デザインでそれがどのように見えるかを示しています。紫色で描かれているのがリコンフィギャラブルパーティション(この例では pblock_pr_block_ins という名前で、ロジックはほとんど含まれていません)です。その形状は 3 つの矩形の和集合として作られています(上記の各 resize_pblock コマンドに並べた 3 つの範囲です)。
この図では、配置済みのロジックがすべてシアンで描かれています。ロジックの大部分はスタティック領域に属しており、それが小さな領域に閉じ込められていることが一目でわかります。
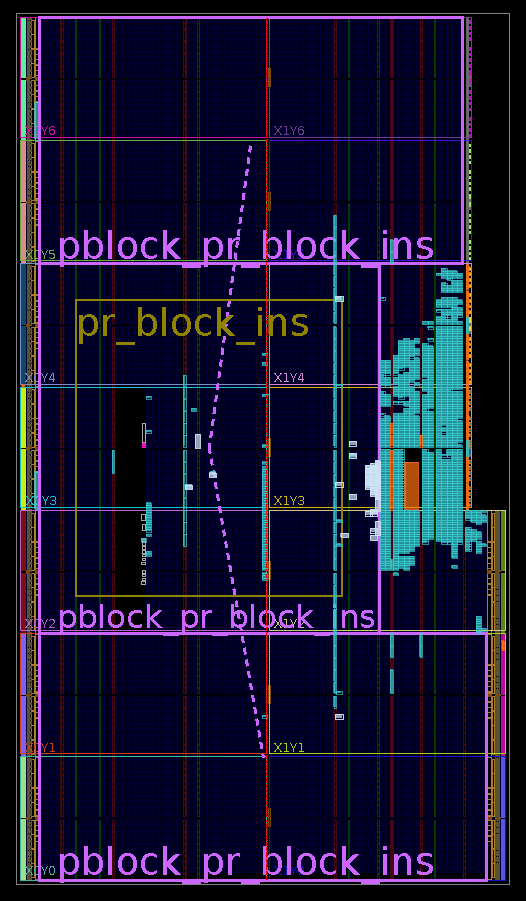
制約で制限されるのは、スライス、RAM、DSP48 だけであることに注意してください。7 シリーズ FPGA の部分再構成が制御できるのは、これらのロジック種別だけです。それ以外のものは、実際には「純粋なロジック」以外のすべてですが、スタティックデザインに属さなければなりません。
UltraScale FPGA 以降では、事実上あらゆるロジックを部分再構成でリロードできます。
Pblock には追加の制約もいくつかありますが、ここで UG909 の第 6 章から第 8 章を繰り返しても意味がありません。
とにかく、実装後デザインを開いて、FPGA の表示をズームイン/ズームアウトしながら、ロジック要素が FPGA 内でどのように並んでいるかを眺めてみるのは良い練習になります。特に、同じ種類のロジックが列(カラム)になっていることに注目してください。列の途中に、一様性を乱すロジック要素がいくつかあることがあります(特に ICAP ブロックや PCIe ブロックなどの特殊なロジック要素です)。
Pblock の話題は部分再構成に固有のものではない点も付け加えておきます。たとえば、このセクションで述べたことはすべて、階層設計のために Pblock を使う場合にも当てはまります。
フロアプランニングの詳細
ここで直感に反する事実をいくつか紹介します。フロアプランニングの図形表現は FPGA マップ上に描く形状ですが、実際に効いてくるのは、その配置制約によって制御されるロジック種別だけです。ですから、FPGA のほぼすべてのスライスが部分再構成用に割り当てられていても、それらのスライスに完全に囲まれた他のロジック要素の島がスタティックロジックに属することは十分あり得ます。たとえば、ICAP ブロック自体が部分再構成に割り当てられた矩形の真ん中にあったとしても、まったく問題ありません。
部分再構成ビットストリームが特定のロジック要素に向けられ、他の要素は無傷のまま残すのであれば、これはそれほど不思議ではありません。では配線はどうなるのでしょう。ICAP ブロックがリコンフィギャラブルロジックの真ん中に突き刺さっていたら、スタティックロジックのスライスへの配線はどうやって引かれるのでしょうか。
この疑問は、2 つ目の直感に反する事実へとつながります。スタティックデザイン用の配線は、リコンフィギャラブル領域の内部にあるリソースを使っています。この配線は部分再構成のプロセス全体を通じて安定したままです。そうでなければスタティックロジックとは言えません。つまり、リコンフィギャラブル領域の内部では、リコンフィギャラブルロジック用の配線は変わりますが、スタティックロジック用の配線は変わりません。このテーマ全体の中で魔法のように感じられる点があるとすれば、まさにこの事実です。また、スタティックロジックと互換性のない部分ビットストリームを使うと FPGA 全体を完全に壊してしまう可能性が高い理由もここにあります。
もちろん逆は成立しません。リコンフィギャラブルロジックは、上記の XDC の例で明示的に列挙されたリソース以外は使用しません。配線リソースに関して言えば、部分再構成ビットストリームがロードされている間、スタティック領域内の何も変化しないので、その意味でリコンフィギャラブルロジックがスタティック領域に影響を与えることはありません。といっても、これはほぼ真実です。リコンフィギャラブル領域の形状が単純な矩形でない場合、Vivado は配線がリコンフィギャラブル領域の外側に出ることがあります。これは配線を改善する目的で、UltraScale FPGA でのみ発生します。
ここまでで明らかなように、フロアプランニングの描画ルールは単純ではありません。幸いなことに、Vivado はフロアプランニングのルール違反に対して、かなり情報量の多いクリティカルワーニング(Critical Warning)を出します。したがって、試行錯誤で適切なフロアプランを見つけるのは合理的な作業方法です。
ペアレント実装とチャイルド実装
リコンフィギャラブルロジックの実装に関して重要なのは、FPGA 内のすべてのパス(path)がタイミング制約を満たさなければならず、それはリコンフィギャラブルロジックがロードされる前と後の両方で成立しなければならないということです。したがって、スタティックロジックから分離したリコンフィギャラブルロジックだけの実装というものはあり得ません。実装は常に、各リコンフィギャラブルモジュールについて FPGA 全体を対象として行われます。そして各実装でタイミング制約(およびその他の制約)が適用されます。
この点を明確にするため、先ほどの moduleA と moduleB の例に戻りましょう。この例では、Vivado は moduleA を含む全体デザインの実装を行い、次に moduleB を含む実装も行います。その副産物として、これらの 2 つの各構成に対する通常のビットストリームファイルが得られます。
強調しておくと、すべての実装は完全な初期ビットストリームと部分ビットストリームの両方を生成します。これは、ペアレント実装かチャイルド実装かを問わず、すべての実装に当てはまります。したがって、FPGA の電源投入時には、これらの初期ビットストリームのいずれでもロードすることができます。
moduleA から moduleB へ部分再構成で移行できるようにするには、スタティックパーティション内のすべてが完全に同一でなければなりません。ロジック自体だけでなく、配置と配線も含みます。これを達成するため、Vivado はあるシナリオ(たとえば moduleA を含む構成)をペアレント実装として実装します。そして、その他のシナリオ(たとえば moduleB)についてはチャイルド実装を行います。その正確な手順は本連載の最終回で詳述しますが、要約すると次のとおりです。
Vivado は、階層設計の場合と同様に、moduleA のペアレント実装を実行することから始めます。つまり、スタティックロジックとリコンフィギャラブルロジックの合成は別々に行われ、フロアプランニング制約によって FPGA 上の別々のサイトに配置されるように強制されます。これらの 2 つの違いを除けば、通常の実装と同じです。特に配置配線(place and route)は、この特定のシナリオにとって最適な結果が得られるように実行されます(フロアプランニング制約や分離合成のために、性能が最適でなくなることはあっても)。
次のステップは、moduleB のチャイルド実装を実行することです。スタティックデザインの合成はペアレント実装の際にすでに済んでいるため、必要ありません。したがって、合成はリコンフィギャラブルロジックについてのみ行われます。
その後、実装はペアレント実装と同様の方法で実行されますが、決定的な違いが 1 つあります。それは、すべてのスタティックロジックの配置配線をペアレント実装の結果と強制的に同一にすることです。この制約のもとで、リコンフィギャラブルロジックの配置配線は最適な結果を目指して行われます。
つまり、ペアレントとチャイルドの関係の要点は、チャイルド実装がペアレント実装が終わった状態から開始し、リコンフィギャラブルロジックを自分のロジックで置き換えることです。その後、チャイルド実装は通常どおり続行しますが、スタティックロジックの領域には一切触れません。
すべてのチャイルド実装はスタティックロジックの配置と配線に適応する必要があるため、デザインを通常どおり実装する場合と比べて、タイミング制約を満たすのが難しくなることがあります。実際には、次の 2 つの障害があります。
- デザインをスタティックロジックとリコンフィギャラブルロジックに階層分離することで、その境界を越えた最適化が妨げられる。
- スタティックロジックの配置配線が、リコンフィギャラブルロジックにとって最適であるとは限らない。
ペアレント実装にどのリコンフィギャラブルモジュールを選ぶかを決めるときは、この点を念頭に置くべきです。たとえば、タイミング制約を満たすのが最も難しいモジュールを選ぶかもしれません。あるいは、スタティックロジックとの接続方法という点で他のモジュールを代表するモジュールを選ぶのもよいでしょう。また、逆に、スタティックロジックの中立的な実装を得るために、実質的にロジックを一切含まないモジュール(「グレイボックス(greybox)」)を選ぶという手もあります。
ビットストリームの使い方に関して、Vivado の部分再構成プロジェクトの実装における考え方では、すべてのビットストリームが最新かつ相互互換になった時点で実装は完了します。言い換えると、最初に FPGA をロードする際には、どの実装の初期ビットストリームを使っても構いません。その後、どの実装の部分ビットストリームでもロードできます。
したがって、最初の「Generate Bitstream」ではペアレント実装とすべてのチャイルド実装が開始されます。それ以降のコンパイルでは、通常どおり Vivado は更新が必要なランだけを実行します。
Dynamic Function eXchange ウィザード
Tools メニューから起動できるこのウィザードの目的は、ペアレント実装とチャイルド実装を定義し、特にどの実装がどのリコンフィギャラブルモジュールを含むかを指定することです。
このウィザードを説明するには、チャイルド実装を追加したときに生成される Tcl コマンドを見るのが最も簡単です。
create_reconfig_module -name bpf -partition_def [get_partition_defs pr ]
add_files -norecurse /path/to/pr_block1.v  -of_objects [get_reconfig_modules bpf]
create_pr_configuration -name config_2 -partitions [list pr_block_ins:bpf ]
create_run child_0_impl_1 -parent_run impl_1 -pr_config config_2 -flow {Vivado Implementation 2020}
この Tcl の並びを、最後の行から最初の行に向かって逆順にたどってみます。
最後の行では、チャイルド実装のラン(Child Implementation run)が作成されます。新しいランには "child_0_impl_1" という名前が付けられ、そのペアレントランには "impl_1" が選ばれています。同様に重要なのは、この新しいランのコンフィギュレーション(configuration)が "config_2" に設定されていることです。
"config_2" は 3 行目で定義されており、"bpf" が "pr_block_ins" という名前のリコンフィギャラブルパーティションに割り当てるリコンフィギャラブルモジュールであることを示しています。"pr_block_ins" は既に登場しましたが、"bpf" とは何でしょうか。
1 行目では reconfig_module が作成され、"bpf" と名付けられています。これはロジックの機能を表す便利な名前であれば何でも構いません。2 行目は、ある Verilog ファイルがこのリコンフィギャラブルモジュールに追加されることを示しています。
つまり、この 4 行は新しいチャイルド実装を作成し、ある Verilog ファイルを合成してリコンフィギャラブルモジュールを作る必要があることを示しています。また、Tcl 環境には "bpf" と "config_2" という 2 つのオブジェクトが作成されます。
Dynamic Function eXchange ウィザードに話を戻します。これは、デザインソース、リコンフィギャラブルモジュール、コンフィギュレーション、実装ラン(implementation run)の関係を GUI で表したツールです。上記のような Tcl コマンドを生成するために、情報を簡単に伝える手段にすぎません。
このツールは過度に複雑に見えるかもしれませんが、それは例が単純だからです。実際のデザインでは、reconfig_module に複数のソースファイルや、場合によっては IP が割り当てられていることがよくあります。そのため GUI のほうが扱いやすくなります。
では、なぜコンフィギュレーション("config_2")が必要なのでしょうか。なぜ "bpf" と "pr_block_ins" の対応付けを create_run コマンドで行わないのでしょうか。この記事が 1 つのリコンフィギャラブルパーティションだけに限定しているとはいえ、これはもっともな疑問です。パーティションが複数ある場合、コンフィギュレーションは「どのパーティションにどのリコンフィギャラブルモジュールを入れるか」を定義するものなので、そうした組み合わせのそれぞれに config_* のような名前を付けるのは理にかなっています。
では、パーティションが複数ある場合、リコンフィギャラブルモジュールの可能な組み合わせごとに実装を行う必要があるのでしょうか。(この疑問は本連載の範囲外なので、次のセクションに読み飛ばして構いません。)
Vivado の実装はデザイン全体、つまりスタティックロジックとリコンフィギャラブルロジックを合わせたものに対して行われ、全体としてタイミング制約を満たすことを保証することを思い出してください。したがって、パーティションが複数ある場合、部分再構成を安全に使うには、すべてのパーティションを同じ実装ランで生成された部分ビットストリームでロードすることです。言い換えれば、すべての部分ビットストリームが同じコンフィギュレーション(たとえば "config_2")で作成されている必要があります。そうすれば、これらの部分ビットストリームの組み合わせは、ツールによって検証済みの実装の結果になります。特に、この実装はタイミング制約を達成することが分かっています。
とはいえ、リコンフィギャラブルモジュール同士が相互に作用しない場合(つまり、すべてのリコンフィギャラブルモジュールのトップレベルポートがスタティックロジックに接続され、互いには接続されていない場合)には、各パーティションを別々に扱って何が問題になるのか、私にはわかりません。実際、異なるランで生成された部分ビットストリームを混在させた場合、Vivado は FPGA 全体のタイミングを明示的に承認しているわけではありません。しかし、スタティックロジックを含むすべてのパスはタイミング制約を満たしており、スタティックロジックはすべての実装ランで完全に同一なのですから、それで十分ではないでしょうか。公式ドキュメントはこの問題について情報を与えていないようです。
配線とパーティションピン(Partition Pins)
パズルにはまだ 1 つ足りないピースがあります。スタティックロジックとリコンフィギャラブルロジックを結ぶ配線です。ペアレント実装は、該当するコンフィギュレーションに含まれるリコンフィギャラブルロジックにとって最適な方法でデザインの配置配線を行うことを思い出してください。しかし、チャイルドのリコンフィギャラブルモジュールは同じリコンフィギャラブルパーティションに収まり、スタティックデザインと接続する必要があります。配線の少なくとも一部はスタティックロジックに属するため、変更できません。
ここで登場するのがパーティションピン(Partition Pins)です。概念的には、リコンフィギャラブルロジックを物理部品、パーティションピンを PCB に接続する金属ピンと考えるとよいでしょう。
ただし実際には、パーティションピンは FPGA の配線リソースの座標系における単なる位置です。スタティックロジックの配線が終わり、リコンフィギャラブルロジックの配線が続き始める場所です。その唯一の重要性は、ペアレント実装とチャイルド実装が、どこに配置するかについて一致していることです。
これらのアンカーポイントを確立するために、LUT やフリップフロップなどの物理リソースは必要ありませんし、追加の配線遅延も生じません。パーティションピンへ至る配線セグメントはもちろん遅延を生みますが、パーティションピン自体は遅延を追加しません。
パーティションピンの位置は、ペアレント実装の実行中にツールが自動的に選択し、チャイルド実装はそれに適応することを強いられます。言い換えれば、スタティックロジックとリコンフィギャラブルロジックの間の配線は、ペアレント実装が決めた位置から始まり、チャイルド実装はリコンフィギャラブルパーティション内で最善を尽くすしかありません。パーティションピンの中には、チャイルドのリコンフィギャラブルロジックにとって不利な位置に置かれるものもあり、タイミング制約を満たすのが難しくなることがあります。
パーティションピンは多くの場合、リコンフィギャラブルパーティションの周辺近くにまとめて配置されます。Vivado は、特定のデザインに特化しすぎないサイトを選ぶように設計されているようです。
ただし、ペアレント実装中にタイミング制約を達成するために必要であれば、パーティションピンはリコンフィギャラブルパーティション内部のどこにでも置かれ得ます。スタティックデザインはリコンフィギャラブルパーティション内部の配線リソースを使うことが許されることを思い出してください。したがって、スタティック配線の一部がリコンフィギャラブルパーティションの中に入り込んでも問題ありません。
タイミング制約とパーティションピンに関する問題を防ぐには、リコンフィギャラブルモジュールの出力ポートをレジスタ出力にし、入力もレジスタでサンプリング(sampling)するのが有益です。同様に、スタティックロジック側もレジスタを挟むのがよいでしょう。実際、可能でありデザインを複雑にしないのであれば、このルールに従うのは常に良い考えです。
グレイボックス(Greybox)
DFX ウィザードに関するもう 1 つの話題はグレイボックスです。Edit Configuration ウィンドウでは、通常のリコンフィギャラブルモジュールの代わりに、グレイボックスをリコンフィギャラブルモジュールとして割り当てることができます。グレイボックスは Vivado が生成するダミーモジュールです。実際のリコンフィギャラブルモジュールのポートに適合しますが、実際のロジックの代わりに、ポートピンごとに 1 個の LUT が置かれます。入力用に生成される LUT はもう一方の端が何にも接続されておらず、出力用の LUT はゼロ値を生成します。ベクタポートの場合、ベクタの各ビットに対して LUT が 1 個作られます。
ペアレント実装でグレイボックスを使うのは必ずしも良い考えではありません。配置配線処理があまりにも簡単になってしまうからです。リコンフィギャラブルモジュール同士が大きく異なる場合でも、ツールに多少の負荷をかけるようなシンプルなモジュールを書くほうがおそらく良いでしょう。
しかし、最小限のロジックだけを含む初期ビットストリームファイルを作る目的であれば、グレイボックスモジュールだけを含むチャイルド実装が役立つことがあります。すべての実装は完全なビットストリームを生成し、それらはすべてまったく同じスタティックロジックを持つため、どれも初期ビットストリームとして使用できることを思い出してください。
クリアリングビットストリーム(UltraScale のみ)
これは UltraScale FPGA にのみ関係します(UltraScale+ には該当しません)。
前述のとおり、すべての実装は 2 つのビットストリームを作成します。1 つはデザイン全体用のビットストリームで、関連するリコンフィギャラブルモジュールを含み、FPGA の初期ロードに使えます。もう 1 つは、同じリコンフィギャラブルモジュールを対象とする部分再構成用のビットストリームです。
UltraScale デバイスでは、各実装で作成される 3 つ目のビットストリーム、「クリアリングビットストリーム(clearing bitstream)」があります。このビットストリームは、部分ビットストリームの前に FPGA へ送る必要があります。FPGA に送るクリアリングビットストリームは、これからロードしようとしているビットストリームではなく、FPGA 内に現在入っているロジックと一致しなければならないことに注意してください。そのため、FPGA の現在の状態を把握しておく必要があります。これは他の FPGA ファミリでは不要な作業です。
クリアリングビットストリームをロードすると、実際にはロジックを変更しなくても、リコンフィギャラブルモジュールはシャットダウンします。このモジュールの出力ポートは、新しい部分ビットストリームがロードされて起動するまで、任意の値を示す可能性があります。
UG909 によれば、誤ったリコンフィギャラブルモジュールのクリアリングビットストリーム(すなわち、FPGA 内にすでにあるロジックと一致しないクリアリングビットストリーム)をロードすると、スタティックロジックも乱れてしまい、再構成メカニズムが誤動作する可能性があります。
Xilinx のドキュメントは、クリアリングビットストリームを先にロードせずに部分ビットストリームをロードした場合に何が起きるかについて、曖昧なように思われます。UG909 の第 9 章には、まず「新しいリコンフィギャラブルモジュールの部分ビットストリームをロードする前に、既存のリコンフィギャラブルモジュールをクリアしなければならない」と書かれています。つまり、クリアリングビットストリームは必須であるという結論になります。
しかし、同じガイドの少し下には、「クリアリングビットファイルがロードされない場合、初期化ルーチン(GSR)は効果がない」とあります。これは、すべての同期要素(原則として RAM とフリップフロップ)が未知の状態で起動してもよいのであれば、クリアリングビットストリームをまったく使わなくてもよいことを示唆しています。私自身、クリアリングビットストリームをスキップして試した限りでは問題は見られませんでしたが、それは何も証明しません。
したがって、UltraScale FPGA では、FPGA に何がロードされているかを常に把握する必要が確かにあります。これはたとえば、リコンフィギャラブルモジュールごとに異なる定数値(ID コード)を持つ出力ポートを追加することで実現できます。これにより、スタティックロジックは現在どのリコンフィギャラブルモジュールがロードされているかを識別できます。このような ID コードは、何はともあれ良いアイデアです。
プラグイン用途とリモートアップデート用途
Vivado が採用しているこのペアレント・チャイルド方式は、私がプラグイン用途(plugin usage)と呼ぶ特定のユースケース向けに設計されているようです。それは、すべての可能な機能を常に FPGA 内に持っておくのではなく、その時々で必要なリコンフィギャラブルモジュールだけをロードして FPGA のコストを下げるという使い方です。たとえば、FPGA が複数の画像フィルタを実装する場合、部分再構成により各フィルタをリコンフィギャラブルモジュールとして実装し、必要なフィルタだけを FPGA にリロードできます。
Xilinx は部分構成のことを「Dynamic Function eXchange(DFX)」と呼んでいますが、これはこの技法の主な意図された用途を反映しているように思われます。
ペアレント・チャイルド方式は、これが部分再構成の目的である場合にうまく機能します。ビットストリームファイルの完全なキットが生成されます。どの初期ビットストリームでも FPGA の初期化に使用でき、後からすべてのリコンフィギャラブルビットストリームを部分再構成に使うことができます。プロジェクトの新しいバージョンがリリースされると、すべてのビットファイルからなるキット全体が置き換えられます。
しかし、もう 1 つの利用パターンがあります。私がリモートアップデート(Remote Update)と呼ぶものです。これは、部分再構成をバージョンアップグレードの手段として使うケースで、場合によっては遠い将来に行われます。このシナリオでは、初期ビットストリームがある時点でリリースされ、その後は変更できません。その後、部分ビットストリームがリリースされますが、これらは初期ビットストリームと互換性がなければなりません。こうした後のリリースは何年にもわたって続くことがあります。
リモートアップデートの場合、ペアレント・チャイルド方式をそのまま使うのは難しいかもしれません。ペアレントの実装をやり直さずにチャイルド実装を実行して新しい部分ビットストリームを得ることは可能ですが、それを長期間にわたってやり続けるのは困難です。たとえば、スタティックロジックのソースコードをうっかり変更すると、ペアレントのデザインが無効になり、ペアレント実装のやり直しが発生します。その結果、新しいスタティックロジックは以前のものと互換性がなくなり、それに基づく部分ビットストリームは元の初期ビットストリームとは使えなくなります。
つまり、部分再構成を FPGA デザインを長期間にわたって順次更新していく方法として使うつもりなら、実装手順にひと工夫が必要です。このテーマについては、本連載の最終回で議論します。
ビットストリームの圧縮
これは部分再構成と直接の関係はありませんが、FPGA の高速起動を確保するために、初期ビットストリームファイルを小さくしたいことがあります。この文脈では、部分再構成はクイックスタート後の立ち上げ処理を完了させる手段になります。これは同じデータソース(たとえば SPI フラッシュ)からでも、まったく別のソース(たとえば PCIe インターフェイス)からでも実行できます。
ビットストリームの圧縮は、初期ビットストリームと部分ビットストリームの両方で許可されています。
圧縮ビットストリームを要求するには、次の行を XDC ファイルに追加します。
set_property bitstream.general.compress true [current_design]
以上で理論的な部分は終わりです。次回では、部分再構成を使うプロジェクトを構成するための実践手順を説明します。