本页是关于 FIFO 的五页系列教程中的第一页。
概述
FPGA FIFO 是一种概念很简单的存储元件:应用逻辑的一部分在 FIFO 的一侧写入数据字;另一部分应用逻辑则在另一侧按完全相同的顺序读出这些数据字(FIFO = First In First Out,先进先出)。
这些数据存放在 FIFO 内部。FIFO 的深度(depth)表示它能存储多少个数据字。位宽(即每个数据字的位数)和深度都是用户配置每个 FIFO 时需要设置的参数。
FIFO 很可能是 FPGA 设计中最常用的 IP 核(IP core)。每当一部分逻辑产生数据,另一部分逻辑消费这些数据时,人们最先想到的解决方案就是在两者之间加一个 FIFO(当然,这并不是说 FIFO 永远是正确方案……)。
对于熟悉命令行界面(尤其是 UNIX / Linux)的人来说,可以把 FIFO 的用法比作命令之间的管道(pipe):一个程序的输出成为另一个程序的输入,而两者之间的神奇机制会处理其余一切。
因为 FIFO 用得实在太普遍,所以 FPGA FIFO 应该怎样表现,实际上已经有了事实上的共识。每家 FPGA 开发软件都会提供一种生成 FIFO IP 模块的方法,供设计使用。不仅如此,这个 FIFO 模块很可能带有一组固定端口,其行为与其他 FPGA FIFO 没有差别。
FPGA 厂商提供的软件可以让你生成符合特定需求的 FIFO。只需在某个 GUI 工具中配置它的属性(位宽、深度,以及其他我稍后会讨论的属性),剩下的事都由工具完成。你唯一需要做的,就是在设计中实例化(instantiation)这个模块。与 FPGA 世界里的许多其他任务不同,这件事确实就这么简单。
由于每个 FPGA 厂商都提供自己的 FIFO IP 核,当然需要把文档读到最细微处。不同 FPGA 厂商描述 FIFO 时使用的术语略有不同,模块端口名称也略有不同。此外,每家厂商提供的附加功能和配置选项也稍有差别。
话虽如此,默认设置通常正好对应着我所说的“基线 FIFO(baseline FIFO)”。在此基础上,肯定还会有一组随时可用的附加功能。
不过,FIFO 在可编程逻辑结构(logic fabric)中的实现方式会因厂商而异,所以理解 FIFO 各项属性的含义,对于充分利用 FPGA 资源非常重要。
总而言之,理解和掌握 FPGA FIFO 只需一次性投入。一旦你在某一款 FPGA 上学会了如何使用它们,换到另一款 FPGA 上就会容易得多。这本身就是 FIFO 如此普及的一个原因。
基线 FIFO
FPGA FIFO 并没有成文的标准,但人们对其行为方式仍然有广泛的共识。
所有 FIFO 都有两个接口,一个用于写入数据字,一个用于读出数据字。先来看一下我所说的“基线 FIFO”的实例化。它有一些重要的变体,我稍后会讲到。
myfifo myfifo_ins
  (
   .rst(rst),       // Asynchronous reset input

   // Write interface ports
   .wr_clk(wr_clk), // Write clock input
   .wr_en(wr_en),   // Write Enable input
   .din(din),       // Write word input
   .full(full),     // Full output

   // Read interface ports
   .rd_clk(rd_clk), // Read Clock input
   .rd_en(rd_en),   // Read Enable input
   .dout(dout),     // Read word output
   .empty(empty)    // Empty output
);
这些端口名称是 Xilinx 工具使用的名称,不过其他 FPGA 厂商也使用类似的名称。
FIFO 模块的端口分为三组:一个复位信号(@rst),我稍后会再谈到它;另外,正如预想的那样,还有一个写接口和一个读接口,每个接口各由四个端口组成。
@din 和 @dout 是两个向量(vector)端口,分别承载写入 FIFO 和从 FIFO 读出的数据字。这些数据字的位宽是在用相关软件工具设置 FIFO 时决定的。你还需要设置 FIFO 的深度,也就是它能容纳多少个数据字。这两个参数会影响 FIFO 消耗多少 FPGA 存储器资源。
时钟
值得注意的是,两个接口各有自己的时钟:@wr_clk 和 @rd_clk。每个接口中的其他端口都与各自的时钟同步。
FIFO 常被用来把数据从一个时钟域(clock domain)搬到另一个时钟域,正是因为它有两个时钟:如果设计中的一部分逻辑与 clk_A 同步,另一部分与 clk_B 同步,你如何让它们协同工作?任何 FPGA 工程师的第一个念头都是:在它们之间放一个 FIFO。这主要是因为跨时钟域(clock domain crossing)是件很让人头疼的事,而使用 FIFO 可以轻松又安全地解决问题。
写接口
写接口很简单:@wr_clk、@wr_en 和 @din 是 FIFO 的输入,而 @full(满)是输出。
当 @wr_clk 上升沿到来时,如果 @wr_en 为高,@din 上的数据就会被压入 FIFO。当 FIFO 已满时,@full(满)端口输出为高。
例如,下面这段波形表示向 FIFO 写入五个数据字:
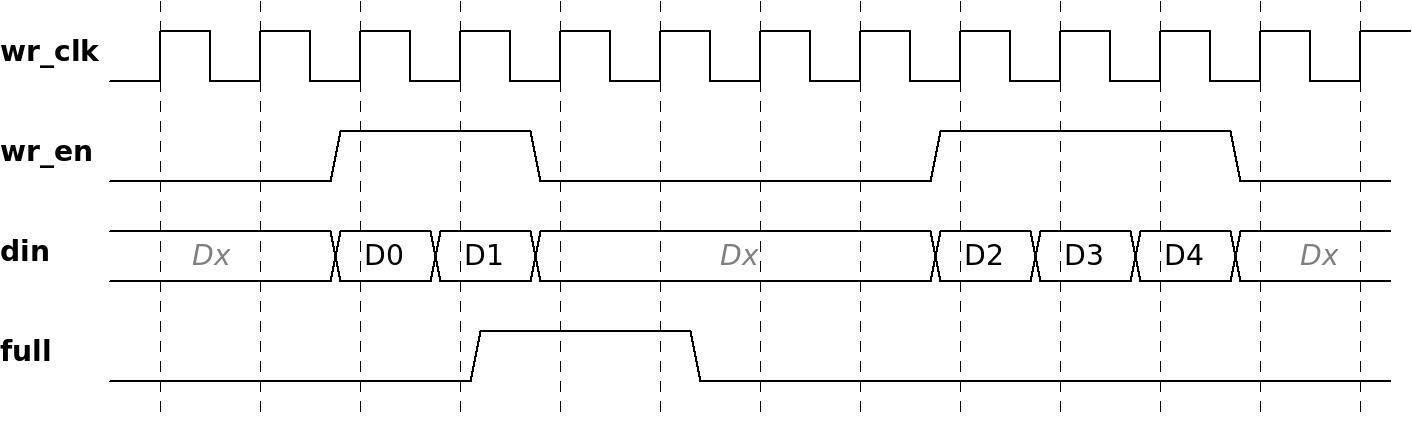
在这个波形中,应用逻辑先写入了 D0 和 D1。FIFO 在成功写入 D1 后把 @full(满)输出拉高,以通知 FIFO 已满。应用逻辑的响应方式是:在同一个时钟周期内把 @wr_en 拉低。几个时钟周期之后,FIFO 又把 @full(满)拉低,表示现在可以继续写入。这很可能是因为另一侧有活动,也就是有数据从 FIFO 中被读走了。
应用逻辑本可以在 @full(满)变为低电平的那个时钟周期就开始写入,但在这个具体例子中,它稍晚才开始。如波形所示,随后又写入了三个数据字。
在波形中,@din 标为“Dx”的地方表示该值被忽略,所以那里无论是什么值都无所谓。例如,在 D1 和 D2 之间标为“Dx”的那一段,@din 可以继续保持 D1,也可以比图中更早地变成 D2,还可以是完全不同的值——结果都一样。
举个简单的编码示例。假设我想在条件允许时,用递增计数的数据字填满 FIFO:
assign wr_en = !full;

always @(posedge wr_clk)
  if (wr_en)
    din <= din + 1;
这个例子说明了 @full(满)与 @wr_en 之间的正确关系:如果 @full(满)为高,@wr_en 必须在同一个时钟周期内为低。假如没有这么做呢?假如我们忽略了 @full(满)信号呢?很可能 FIFO 在这种情况下会忽略 @wr_en。于是它的行为就仿佛其 @wr_en 端口接的是下面这个 @the_real_wr_en:
assign the_real_wr_en = wr_en && !full;
不过,有些 FPGA 工具允许配置 FIFO 时不带这种安全机制。如果这样配置,在 FIFO 已满时仍试图写入数据,那几乎任何事都可能发生。
不管怎样,都应该尊重 @full(满)信号,否则看起来就好像数据悄悄漏掉了一样。以刚才的例子来说:如果 @wr_en 一直为高,@din 就会持续递增,不管数据是否真的被写入了 FIFO。这样一来,在另一侧读出数据时,递增序列就会不连续。
注意,@full(满)只可能因为一次写周期而从低变高,也就是在 @wr_en 为高的时钟上升沿之后。FIFO 被复位时除外,这一点稍后再讨论。
读接口
读接口与写接口很相似,但又不完全相同。@rd_clk 和 @rd_en 是 FIFO 的输入,@dout 和 @empty(空)是输出。
当 @rd_clk 上升沿到来时,如果 @rd_en 为高,就会从 FIFO 的存储器中读出一个新数据字,并且 @dout 会在这个上升沿之后更新为新值,也就是在紧接下来的那个时钟周期。当 FIFO 为空时,@empty(空)端口输出为高。
下面这段示例波形展示了从 FIFO 读出五个数据字:
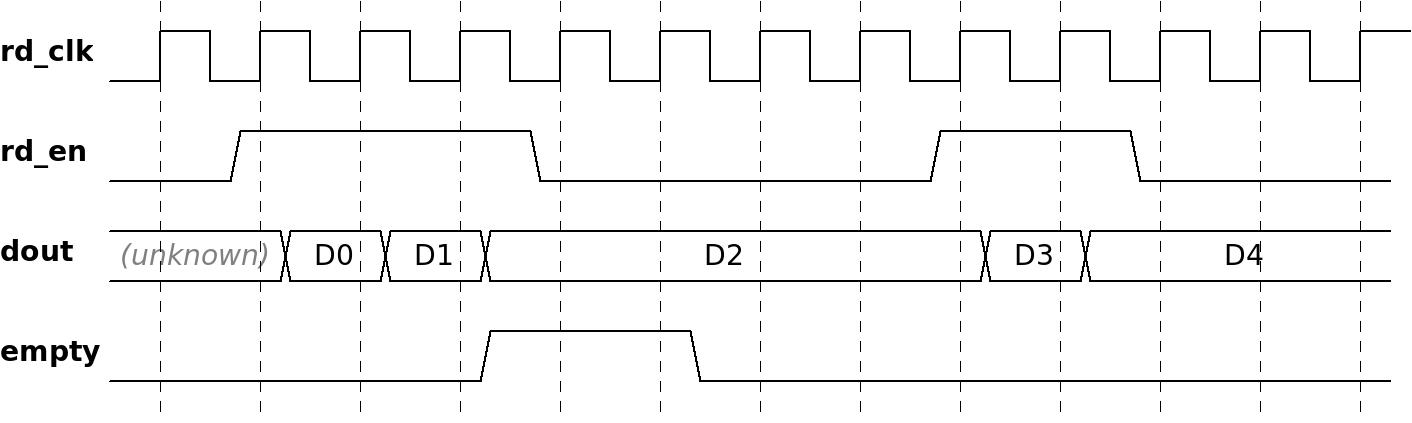
在这段波形中,应用逻辑先读出了三个数据字。当 @empty(空)变高(同时 D2 出现在 @dout 上)后,应用逻辑在同一个时钟周期内把 @rd_en 拉低。和前面一样,在 @empty(空)变低(因为另一侧有数据写入 FIFO)的那个时钟周期,即使马上把 @rd_en 重新拉高,也是可以的。但应用逻辑没有这么做,而是等了好几个时钟周期,然后才继续读出了两个数据字。
这里有一点小补充:如果你把这个波形与上面那个波形对比,可能会注意到:一共写入了五个字,也读出了五个字。那为什么 @empty(空)没有在 D4 出现的同时变高?嗯,因为我想展示的是:即使 FIFO 不为空,也可以停止读取。所以,为了这个假想的例子,我们假定当时还有更多数据字被写入 FIFO,因此在读出 D4 之后,FIFO 并没有变空。
注意,当 @rd_en 为低时,@dout 会保持原来的值。应用逻辑可以依赖这一点:@dout 上总是最后一次从 FIFO 读出的数据字的值(复位后除外)。
更重要的是,要注意 @dout 的新值出现在 @rd_en 为高的上升沿之后。因此,FIFO 的行为类似下面这段 Verilog 代码:
always @(posedge rd_clk)
  if (rd_en && !empty)
    dout <= next_word_to_show;
这段虚构的 Verilog 代码也说明了一个事实:大多数 FIFO 在 @empty(空)为高的时钟周期内会忽略 @rd_en。与写接口一样,如果某个时钟周期 @empty(空)为高,那么 @rd_en 就不应该为高。再次提醒:某些 FIFO 可以配置成没有这种保护机制,所以不要违反这条规则。
@empty(空)只可能因为一次读周期而从低变高,也就是在 @rd_en 为高的时钟上升沿之后。唯一例外是 FIFO 被复位时。
举个例子,下面是一段简化的 Verilog 代码片段(不含复位),它从 FIFO 中读出数据字,并计算累计和:
assign rd_en = want_to_read_now && !empty;

always @(posedge rd_clk)
  begin
    rd_en_d <= rd_en;

    if (rd_en_d)
      sum <= sum + dout; // Don't try this at home: @sum is never reset.
  end
为了演示,我加了一个 @want_to_read_now 信号,用来表示逻辑希望读取数据。不过,只有 FIFO 不空时,@rd_en 才为高。
请注意 @rd_en_d,它保存的是延迟一个时钟周期后的 @rd_en 值。因此,当 @dout 上出现一个新的有效值时,@rd_en_d 恰好为高。这就是为什么用 @rd_en_d 作为接收 @dout 值的条件。@rd_en 与 @dout 之间的这个延迟会让事情变得有些麻烦,正如这个例子所示。
同步与延迟
因为我上面把写和读的波形分开画了,所以它们漏掉了一个重要问题:从向空 FIFO 写入第一个数据字开始,到 @empty(空)端口变为低电平,需要几个时钟周期。同样,从向已满的 FIFO 读出第一个数据字开始,到 @full(满)端口变为低电平,也需要几个时钟周期。
这是因为“有数据写入 FIFO”这个信息必须先跨越两个时钟域进行传播,之后才能到达 FIFO 的另一侧。跨时钟域所需的逻辑会造成几个时钟周期的延迟,所以 @empty(空)端口会稍晚响应;@full(满)端口也是同样的道理。
那么这个延迟到底是几个时钟周期?它取决于很多因素,其中也包括在特定时刻两个时钟边沿之间的时间关系。简而言之:很难说。
影响该延迟的因素之一是同步级数(synchronization stages),它通常也是 FIFO 可配置的参数。两级是常见选择,不过也可以选择更大的数值。这有助于提高 FIFO 的可靠性,代价是多占用一些逻辑资源。同时,如前所述,它也会增加 @empty(空)和 @full(满)端口的延迟。
所以,如果你真想宠爱一下你的 FIFO,可以把同步级数增加到三级,以获得一种绝对超级安全的感觉。
复位输入
所有 FPGA FIFO 都有复位信号。由于 FIFO 使用两个时钟,这个复位信号并不要求与其中任何一个时钟同步,因此它是异步复位(asynchronous reset)。FIFO 的内部逻辑会在两个时钟域内分别对该复位信号进行同步。
那么复位做什么呢?首先,它会清空 FIFO,并把 @empty(空)置为高。如果 FIFO 中原先有数据,这些数据都会丢失。
至于 @full(满)输出,常见(而且推荐)的做法是:复位后让该输出保持为高,直到 FIFO 准备好接收数据(也就是可以进行写周期)为止。不过,这种行为有时是可选的,所以建议查阅所用 FIFO 的文档来确认。毕竟,复位之后 FIFO 并不是真的满了。此外,因为复位而把 @full(满)拉高,也违反了前面提到的规则:@full(满)只应因为写入数据而变高。
很重要的一点是:从复位信号有效,到 @empty(空)端口和 @full(满)端口变高,需要几个时钟周期。这是因为 FIFO 内部有同步逻辑。所以,在复位有效前后的几个时钟周期内,状态会有些“模糊”。要确保应用逻辑不要在复位前后的这几个时钟周期内尝试读写 FIFO。
尽管复位信号是异步的,它仍然应当是 FPGA 中某个寄存器(触发器)的输出。复位不应该来自组合逻辑(combinatorial logic)的输出,因为毛刺可能会让 FIFO 收到非预期的复位。
事实上,许多 FPGA 工程师错误地认为,把几乎任何信号接到复位端口上都能工作。但 FPGA 厂商对复位信号可能会有一些出人意料的要求。例如,下面这段话摘自 Xilinx 的FIFO 产品指南(PG057):
如果异步复位的宽度只有一个最慢时钟周期,并且其有效沿非常接近最慢时钟的上升沿,那么复位检测可能无法正确进行,从而引发意外行为。为避免这种情况,通常建议让异步复位至少保持 3 [ ... ] 个最慢时钟周期……
(第三章,“复位(Resets)”)
因此,Xilinx 建议复位有效时间至少为三个时钟周期。我不确定有多少人知道这条建议。无论如何,请务必阅读你的 FPGA 厂商提供的 FIFO 用户指南,了解如何正确产生这个复位信号。
FIFO 的实现方式
尽管厂商的软件工具会处理好一切,让 FIFO 正常工作,但最好还是了解 FPGA 中的哪些资源被使用了,尤其是为了避免某种资源短缺。
每种 FPGA 都有自己的实现选项,我简要介绍几种常见类型:
- 完全由硬件实现。这通常意味着存储部分使用块 RAM(block RAM),除此之外,控制 FIFO 的逻辑也是用芯片中的硬件实现的,而不是在可编程逻辑结构中搭出来的。这样虽然省不下多少逻辑,但硬件实现可能更有利于提高工作频率。主要缺点是这类 FIFO 的功能仅限于硬件已经实现的内容,因此 FIFO 容量可能相对有限,甚至一些很基本的功能也可能缺失。
- 块 RAM FIFO。这是最常见的一类。FIFO 由若干块 RAM 组成,具体数量取决于要达到的 FIFO 位宽和深度。控制 FIFO 的逻辑则在可编程逻辑结构中实现。
- 分布式 RAM FIFO。它与块 RAM FIFO 类似,不过它使用逻辑片(slice)而不是块 RAM 来充当存储。别忘了,大多数 FPGA 都可以把 slice 中的查找表(LUT)用作 RAM,所以当 FIFO 深度较浅时,这是一个很合适的选择。该选项通常适用于深度为 32 个字或更少的 FIFO,但具体取舍仍取决于设计和 FPGA 系列。
- 基于移位寄存器的 FIFO。这是分布式 RAM FIFO 的一种特别形式:由于逻辑片也可以配置成移位寄存器(shift register),利用这一点可以省下少量逻辑资源。