범위
이 페이지는 FIFO에 관한 다섯 편의 시리즈 중 두 번째 글입니다. 이전 페이지에서 FIFO의 기본을 소개했으니, 이제는 일반적인 변형과 추가 기능을 다룰 차례입니다. FIFO는 아래에서 설명하는 옵션들을 조합하여 구성하는 경우가 많습니다.
단일 클록 FIFO
'기준 FIFO'에는 서로 무관한 클록(unrelated clocks) 입력이 두 개 있지만, 양쪽의 신호가 같은 클록에 동기화되어 있는 경우도 많습니다. 같은 클록을 @wr_clk와 @rd_clk에 연결해도 전혀 문제가 없습니다. 하지만 두 클록 입력에 같은 클록이 들어가므로 클록 도메인 간 이동(clock domain crossing)이 필요 없고, 따라서 FIFO 안에 불필요한 로직이 들어가게 됩니다. 클록 도메인(clock domain)에 대한 자세한 내용은 이 글을 참고하세요.
그래서 모든 FPGA 벤더는 FIFO를 두 범주로 제공합니다. 듀얼 클록 FIFO(dual-clock FIFO)와 단일 클록 FIFO(single-clock FIFO)입니다. 다른 이름도 자주 쓰입니다. 독립 클록 FIFO(independent clock FIFO), 공통 클록 FIFO(common clock FIFO), 비동기 FIFO(asynchronous FIFO), 동기 FIFO(synchronous FIFO) 등이 그것입니다. 이전 페이지에서 소개한 '기준 FIFO'는 듀얼 클록 FIFO(dual-clock FIFO)입니다.
단일 클록 FIFO에는 동기화 로직이 없습니다. 모든 로직이 같은 클록에 동기화되어 있기 때문입니다. 따라서 리셋 입력도 다른 포트들이 쓰는 것과 같은 클록에 동기화되어 있어야 합니다.
FPGA 로직을 낭비하지 않는 것 외에도, 단일 클록 FIFO를 쓸 좋은 이유는 명확성입니다. 두 개의 클록이 관여할 의도가 없다는 점을 크고 분명하게 선언하는 방법이기 때문입니다.
요컨대, FIFO가 두 클록 도메인 사이를 연결하는 데 쓰이지 않는다면 단일 클록 FIFO를 선택하세요.
FWFT FIFO
이전 페이지에서 강조했듯이, 기준 FIFO에서 데이터를 읽는 절차는 @rd_en을 high로 만든 다음, @dout 출력에서 그 값을 다음 클록 사이클에 얻는 것입니다. 이는 다소 직관에 반합니다. 데이터가 이미 FIFO 안에 있는데 왜 요청을 해야 할까요? FIFO가 그냥 @dout 포트에 값을 올려놓고 "이것을 써도 된다"고 알려주면 안 될까요?
그래서 정확히 그렇게 동작하는 일반적인 변형이 있으며, 이를 First Word Fall Through FIFO(FWFT)라고 합니다. 가끔은 read-ahead, show-ahead, look-ahead라고도 부릅니다. FWFT FIFO의 반대 개념은 흔히 '표준 FIFO(Standard FIFO)'라고 합니다. (표준이 어디 있는지 보여주실 분 계신가요?)
아이디어는 단순합니다. FWFT FIFO가 empty(비어 있음) 상태에서 벗어나면(데이터가 쓰였기 때문입니다), 첫 번째 워드를 @dout에 내놓습니다. 애플리케이션 로직은 @rd_en을 high로 계속 유지하면서 워드를 읽습니다. 따라서 차이는 첫 번째 워드에 관한 것뿐입니다.
하지만 FWFT FIFO를 더 쉽게 이해하려면 두 포트의 의미가 바뀌었다는 점을 깨닫는 것이 좋습니다. FWFT FIFO에서 @rd_en은 사실 "방금 @dout의 데이터를 소비했으니 다음 것을 내놓아도 된다"는 뜻입니다. 그리고 @empty는 사실 "@dout이 유효하지 않다"는 뜻입니다.
변하지 않은 것은 @empty가 high일 때 @rd_en도 high가 되면 안 된다는 점입니다. 유효하지 않은 데이터를 소비했다고 말할 수는 없으니까요. 규칙은 그대로이지만 이유는 다릅니다.
다음 파형은 FWFT FIFO에서 읽기를 수행하는 모습을 보여줍니다.
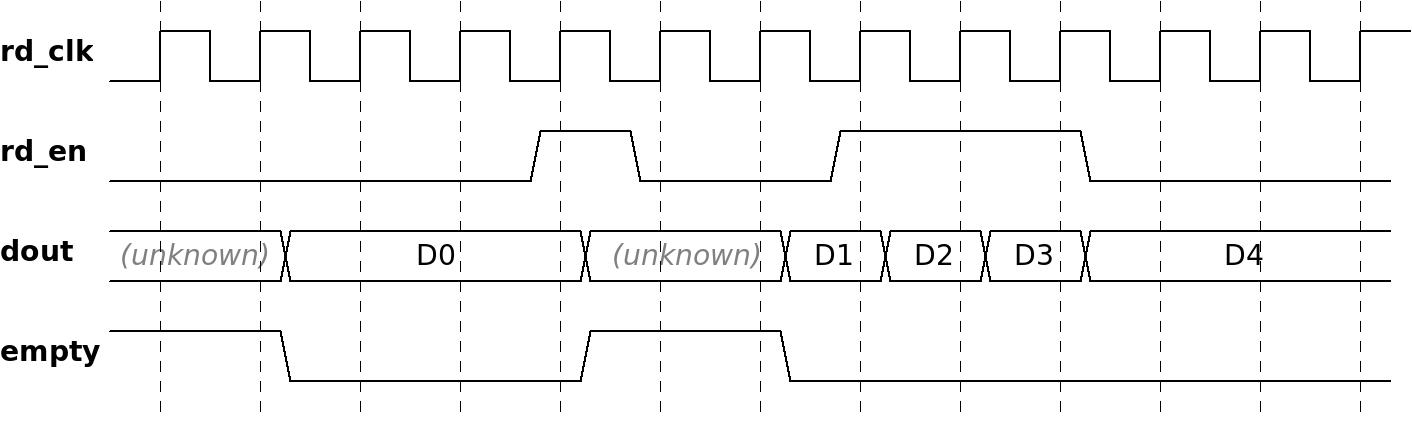
@rd_en이 low인 동안 @dout에 첫 번째 유효한 값이 나타나고, @empty가 low로 바뀌는 시점과 유효한 값이 나타나는 시점이 같다는 점에 유의하세요. 방금 언급했듯이 FWFT FIFO에서 @empty는 "@dout이 유효하지 않음"을 뜻하며, 파형도 이를 반영합니다.
또한 @rd_en의 첫 번째 펄스는 FIFO에서 새 값을 읽은 것이 아니라, @empty가 다시 high로 바뀌도록 만들었습니다. 따라서 @dout의 값도 그와 동시에 알 수 없는 상태가 되었습니다. 실제로 @empty가 high로 바뀔 때 @dout는 보통 변하지 않지만, 그런 동작에 의존해서는 안 됩니다.
그 후 FIFO는 다시 @dout에 값을 내놓고 @empty를 low로 바꿉니다. 애플리케이션 로직은 세 개의 워드를 읽은 다음 @rd_en을 low로 바꿉니다. 모두 합하면 애플리케이션 로직은 FIFO에서 네 개 또는 다섯 개의 워드를 소비했습니다.
파형만으로는 애플리케이션 로직이 D4의 값까지 사용했는지 알 수 없습니다. 다섯 번째 워드를 무시했을 수도 있고, 그 값을 사용했을 수도 있습니다. 파형에서 분명한 것은, 애플리케이션 로직이 네 클록 사이클 후에 @rd_en을 low로 유지해서 FIFO가 @dout를 계속 갱신하는 것을 허용하지 않았다는 점뿐입니다.
또 한 가지 알아둘 점은 FIFO 메모리 안에 더 많은 데이터가 남아 있는지 알 수 없다는 것입니다. 이 파형의 마지막에 @empty가 low라는 사실은 단지 @dout가 유효하다는 뜻일 뿐입니다.
이제 이전 페이지의 Verilog 예제를 수정해 보겠습니다. 아래 코드도 FIFO에서 나오는 모든 워드의 누적 합계를 계산합니다.
assign rd_en = !empty; // If @dout's value is valid, it's consumed.

always @(posedge rd_clk)
  if (!empty) // FIFO is FWFT, so !empty means @dout contains valid data
    sum <= sum + dout; // Don't try this at home: @sum is never reset.
앞선 예제와 달리 이 코드는 FWFT FIFO를 사용하므로, 이전 클록 사이클의 @rd_en 값을 담아 두는 레지스터가 필요 없습니다. 대신 @empty가 low일 때 @dout의 값을 소비하면 됩니다. 이 간단한 규칙이 통하는 이유는 @empty가 low일 때 @rd_en이 high이므로, FIFO에서 나온 각 워드가 정확히 한 클록 사이클 동안 @dout에 유효하게 남기 때문입니다.
FWFT 주제를 다소 동떨어진 관점으로 마무리하겠습니다. 표준 FIFO와 FWFT FIFO의 차이는 임의의 두 로직 모듈 사이의 데이터 흐름에 관한 근본적인 문제를 그대로 반영합니다. 수신 측이 데이터를 요청해야 하는가? 아니면 송신 측이 가능한 한 빨리 데이터를 제시하고, 수신 측은 계속 진행해도 되는지만 확인하는가? 한 모듈이 다른 모듈로 데이터를 전달할 때, 특히 두 모듈이 이 문제에 대해 서로 동의하고 있는지 항상 스스로에게 물어보세요.
비대칭 FIFO
보통 @din과 @dout의 폭을 서로 다르게 설정할 수 있습니다. 예를 들어 32비트 워드로 데이터가 FPGA에 도착하지만, 애플리케이션 로직이 그 데이터를 바이트 단위, 즉 워드당 8비트로 처리해야 한다면 유용합니다. 이 경우 쓰기 쪽 폭을 32비트로, 읽기 쪽 폭을 8비트로 설정하면 됩니다. 한 번의 쓰기 사이클로 들어온 워드를 소비하는 데 네 번의 읽기 사이클이 필요하다는 점만 빼면, 양쪽 모두 평소처럼 동작합니다.
읽기 쪽 폭이 쓰기 쪽보다 넓으면 예상한 대로 동작합니다. FIFO에 쓰인 데이터는 그 데이터가 읽기 쪽 폭만큼 쌓여 한 워드를 채울 때까지 읽기 쪽에서 이용할 수 없습니다.
워드가 어떤 순서로 묶이는지에 대해서는 모든 FIFO가 리틀 엔디언(Little Endian)을 사용하는 것으로 보입니다. 예를 들어 어떤 FIFO가 32비트 워드를 8비트 워드로 묶는다면, FIFO에서 읽히는 첫 번째 워드의 비트 범위는 [7:0], 그 다음은 [15:8], [23:16], [31:24] 순서입니다.
이 기능을 사용하려면 언제나 문서를 확인하세요.
@empty와 @full에 대한 조합 논리 의존성
@empty 포트와 @full 포트에는 공통적인 단점이 있습니다. 애플리케이션 로직이 같은 클록 사이클 안에 응답해야 한다는 것입니다. 즉, @rd_en은 @empty에 의존하는 조합 논리(combinatorial logic) 함수여야 두 신호가 같은 클록 사이클에 high가 되는 일을 막을 수 있습니다. 앞서 말했듯 이것은 금지되어 있습니다. 마찬가지로 @wr_en도 @full에 의존하는 조합 논리 함수여야 합니다.
조합 논리 함수를 사용하면 타이밍 제약 조건(timing constraints)을 달성하는 데 걸림돌이 될 수 있습니다. 클록 주파수가(FPGA 사양에 비해) 높거나 논리 함수가 복잡하면 문제가 될 수 있습니다. 문제가 생기는 주된 이유는 @rd_en과 @wr_en이 모두 데이터를 생성하거나 소비하는 로직에서 자주 쓰이기 때문입니다. 특히 여러 로직의 클록 인에이블(clock enable)을 계산하는 논리 함수가 이들 신호에 의존할 수 있습니다. 예를 들어 FIFO에서 나오는 데이터를 처리하는 긴 파이프라인(pipeline)이 있다면, FIFO로부터의 데이터 흐름이 잠시 멈추는 동안 파이프라인의 모든 로직이 멈추어야 합니다.
사실 정확히 말하면, 그런 조합 논리 함수를 피하는 방법도 있습니다. @wr_en이 레지스터로 선언되어 있고, @want_to_write가 현재 시점에 쓰고자 하는 애플리케이션 로직의 필요를 나타내는 신호라고 가정해 보겠습니다. 이렇게 하면 됩니다.
always @(posedge wr_clk)
  wr_en <= want_to_write && !wr_en && !full;
이렇게 하면 @wr_en과 @full이 같은 클록 사이클에 high가 되는 일이 없습니다. @full은 @wr_en이 high였던 클록 사이클의 다음 사이클에서만 high로 바뀔 수 있기 때문입니다. 수식의 !wr_en 부분은 @wr_en이 두 클록 사이클 연속으로 high가 되는 것을 막습니다. 따라서 @full이 high로 바뀌면 첫 클록 사이클에서는 !wr_en 때문에 @wr_en이 low가 됩니다. 그 이후에는 @full 자체 때문에 @wr_en이 low로 유지됩니다.
하지만 이 해법에서는 @wr_en이 절반 동안 low여야 합니다. 결과적으로 FIFO가 낼 수 있는 데이터 전송률의 50%만 사용하게 됩니다. 이는 대개 받아들이기 어렵습니다.
@rd_en에도 같은 해법을 적용할 수 있으며, 데이터 전송률의 절반밖에 사용하지 못한다는 같은 문제가 있습니다.
이 논의는 다음 절인 'almost' 포트들로 이어지기 위한 것이었습니다.
Almost full, almost empty 및 유사 포트
FIFO에는 옵션 포트 두 개, 즉 @almost_full 포트와/또는 @almost_empty 포트를 추가할 수 있습니다.
@almost_empty는 @rd_clk에 동기화되며 @empty와 비슷하지만 약간의 차이가 있습니다. @almost_empty는 FIFO가 empty(비어 있음) 상태일 때 high이고, FIFO에서 읽을 워드가 정확히 하나 남아 있을 때에도 high입니다.
마찬가지로 @almost_full은 @wr_clk에 동기화되며, FIFO가 full(가득 찬) 상태일 때 high이고 FIFO에 정확히 한 워드를 써도 될 때에도 high입니다.
이 두 출력 포트의 이름은 FPGA 벤더와 벤더가 제공하는 소프트웨어에 따라 다르지만, 같은 기능을 가진 포트를 추가할 수 있는 옵션은 대개 제공됩니다. 다만 특정 FIFO 변형에서는 이러한 포트를 지원하지 않을 수도 있습니다.
이 포트들이 어떻게 도움이 될까요? 다음과 같이 하면 문제없이 동작하기 때문입니다.
always @(posedge wr_clk)
  wr_en <= want_to_write && !almost_full;
조합 논리가 필요 없고, 쓰기 사이클의 절반을 건너뛸 필요도 없습니다. @almost_full이 high가 된 클록 사이클에는 @wr_en이 아직 low로 바뀌지 못하고, 다음 클록 사이클에서야 low로 바뀝니다. 결과적으로 @almost_full이 high로 바뀐 뒤에도 쓰기 동작이 한 번 더 일어날 수 있습니다. 하지만 워드 하나를 담을 자리가 있으므로 문제없습니다.
반면 @want_to_write가 FIFO를 채우는 동안 계속 high로 유지되면, 마지막 쓰기 동작으로 FIFO가 완전히 full(가득 찬) 상태가 됩니다. 그렇지 않으면 FIFO가 거의 full(가득 찬) 상태에서 멈출 가능성이 있습니다. @want_to_write 때문에 @wr_en이 low가 되면 FIFO가 완전히 full(가득 찬) 상태가 되지 않으므로, 다시 쓰려고 해도 기회가 없습니다. @almost_full은 반대쪽에서 FIFO에서 데이터를 읽을 때만 low로 바뀌므로, 그때는 FIFO에 두 개 이상의 워드 자리가 있습니다.
그런 경우가 실제로 문제가 되는 일은 드물지만, 논의를 위해 마지막 워드까지 사용하도록 보장하는 방법은 다음과 같습니다.
always @(posedge wr_clk)
  wr_en <= want_to_write && (!almost_full || (!full && !wr_en));
이 @wr_en 수식은 대부분의 경우 @almost_full에 의존합니다. 정확히 한 워드를 써도 되는 상황, 그때만 @wr_en이 @full과 @wr_en에 의존하며, 앞서 !wr_en을 사용한 수식과 비슷합니다.
하지만 마지막 @wr_en 수식이 실제로 유용할지는 상당히 의문입니다.
@almost_empty에 대한 이야기도 비슷하므로, 다음과 같이 해도 동작합니다. 다만 그대로 복사해서 쓰지는 마세요.
always @(posedge rd_clk)
  rd_en <= want_to_read && !almost_empty;
@almost_full과 마찬가지로 마지막 워드 문제가 있습니다. @want_to_read 때문에 @rd_en이 low가 되면, FIFO에 더 많은 데이터가 채워질 때까지 그 기회를 잃습니다. @almost_full의 경우와 달리 이 문제는 특정 시나리오에서 분명히 문제가 될 수 있습니다. @almost_empty가 high인데 FIFO가 empty(비어 있음) 상태가 아니라면, FIFO 안에 읽으려고 했던 데이터가 들어 있는데 그 데이터가 FIFO에 갇혀 버린 것을 의미하기 때문입니다.
따라서 안전한 방법은 다음과 같습니다.
always @(posedge rd_clk)
  rd_en <= want_to_read && (!almost_empty || (!empty && !rd_en));
채움 카운터
애플리케이션 로직은 종종 일정한 덩어리 단위로 동작합니다. 예를 들어 FIFO에서 고정 길이의 패킷을 읽어 어떤 물리적 매체로 전송하는 로직이 그렇습니다. 데이터가 FIFO에 저장되어 있으므로, 애플리케이션 로직은 읽기를 시작하기 전에 패킷 하나를 채울 만큼 충분한 데이터가 있는지 알아야 합니다.
마찬가지로 애플리케이션 로직은 정해진 양의 데이터를 만들어 FIFO에 저장하려는 경우가 많습니다. 예를 들어 외부 메모리에서 버스트(burst) 데이터를 읽어 오는 경우가 그렇습니다. 버스트를 완료할 수 있을 만큼 FIFO에 자리가 충분하지 않으면 동작을 시작해서는 안 됩니다.
이런 용도로 FIFO는 보통 채움 카운터(fill counter), 프로그래머블 empty(programmable empty) 포트, 그리고 프로그래머블 full(programmable full) 포트를 지원합니다. 채움 카운터(때로는 데이터 카운터(data counter)라고도 함)는 FPGA 벤더에 따라 형태가 매우 다양하므로 FIFO 문서를 주의 깊게 읽어야 합니다. 특히 다음 세 가지에 유의해야 합니다.
- 카운터는 어느 클록에 동기화되는가? 말할 필요도 없이, 카운터를 사용하는 로직과 같은 클록이어야 합니다.
- 카운터는 무엇을 알려주는가? '읽기 카운터'는 보통 FIFO에 저장된 워드 수를 나타냅니다. 그렇다면 '쓰기 카운터'는 어떨까요? 역시 저장된 워드 수일까요, 아니면 FIFO가 full(가득 찬 상태)이 되기 전에 쓸 수 있는 워드 수일까요?
- 카운터가 보장하는 것은 무엇인가? 채움 카운터는 보통 그 용도에 비추어 비관적(pessimistic)입니다. 예를 들어 '읽기 카운터'는 FIFO에 실제로 저장된 워드 수보다 일시적으로 적은 값을 내놓을 수 있습니다. 이는 FIFO에 워드가 쓰이는 동안 발생합니다. 이런 카운터는 쓰기 동작에는 늦게 반응하여 값을 올리고, 읽기 동작에는 일찍 반응하여 값을 내리기 때문입니다. 이런 특성은 @rd_en을 제어하는 로직에 사용할 때는 타당하지만, 그런 카운터를 @wr_en을 제어하는 로직에 사용하면 오버플로(overflow)가 발생할 수 있습니다. 그런 용도로는 '쓰기 카운터'가 있습니다. 그래도 문서의 자세한 내용을 반드시 읽어 보세요.
그뿐 아니라, @almost_empty와 @almost_full의 확장 버전인 프로그래머블 empty와 프로그래머블 full도 있습니다. 채움 카운터를 사용하는 방식이 거의 틀림없이 아래와 같을 테니,
assign dont_start_reading = (rd_data_count < 64);
그 신호를 직접 제공하고 prog_empty라고 부르면 어떨까요? 역시 FIFO 문서를 주의 깊게 읽으세요.
다시 한번 강조하지만, FIFO의 마지막 워드까지 읽는 것이 중요하다면 여러분의 로직이 실제로 그렇게 동작하는지 스스로 확인하세요. 이 질문은 앞서 @almost_empty에 대해 논의한 내용과 비슷합니다.
말할 필요도 없이, 이런 추가 포트가 필요하면 FIFO를 구성할 때 요청해야 합니다.
AXI 인터페이스
이 주제는 FIFO와 직접 관련이 없지만, FIFO와 관련해 자주 등장하는 용어이므로 혼동을 피하기 위해 언급해 둡니다.
AXI는 ARM이 도입한 AMBA 표준에 정의된 인터페이스 모음입니다. 예상할 수 있듯이 AXI 인터페이스가 붙은 FIFO는 대개 CPU의 주변 장치(peripheral)로 동작하기 위한 것입니다.
기준 FIFO의 인터페이스는 AXI 인터페이스와 대비하여 흔히 '네이티브(native)' 인터페이스라고 부릅니다.
AXI 인터페이스에는 두 가지 주요 유형이 있습니다. '일반' AXI(보통 AXI3, AXI4 또는 AXI Lite)는 주소와 데이터를 가진 버스(bus)입니다. 두 번째 유형인 AXI-S(streamed AXI)는 데이터 스트림용이며, 데이터는 패킷으로 나뉠 수도 있습니다.
FIFO를 AXI3/AXI4 또는 AXI Lite로 구성하면, 이 인터페이스를 통해 주소가 있는 주변 장치처럼 CPU에 연결할 수 있도록 추가 로직이 더해집니다. 이는 완전히 다른 주제이므로 더 깊이 설명하지는 않겠습니다.
다만 스트리밍 인터페이스는 FIFO의 동작과 다소 비슷하므로, AXI-S 인터페이스의 핸드셰이크(handshake) 신호를 '네이티브(native)' 인터페이스 신호로 변환할 수 있습니다. AXI-S에는 처리해야 할 다른 신호들도 함께 딸려 오는 경우가 많다는 점에 유의하세요.
따라서 FIFO에 쓰기 위한 AXI-S 신호가 @axi_w_valid, @axi_w_ready, @axi_w_data로 주어진다면, 이를 '표준(standard)' FIFO의 포트에 다음과 같이 연결할 수 있습니다.
assign axi_w_ready = !full;
assign wr_en = axi_w_valid && axi_w_ready;
assign din = axi_w_data;
마찬가지로 FIFO에서 읽기 위한 AXI-S 신호 @axi_r_valid, @axi_r_ready, @axi_r_data는 FWFT FIFO의 포트에 다음과 같이 연결할 수 있습니다.
assign axi_r_valid = !empty; // Non-empty means valid with FWFT FIFOs
assign rd_en = axi_r_valid && axi_r_ready;
assign axi_r_data = dout;
다시 말하지만, 이 방식이 동작하려면 FIFO가 FWFT 변형이어야 합니다.
이상으로 FIFO에 관한 이 시리즈의 두 번째 페이지를 마칩니다. 다음 페이지에서는 단일 클록 FIFO를 Verilog로 구현하는 방법을 보여드립니다.